Descubre herramientas de IA de calidad
Reúna las principales herramientas de inteligencia artificial del mundo para ayudar a mejorar la eficiencia laboral

Artículos publicados por SamuelAdams
En la Conferencia Mundial sobre IA de 2026, Wang He, director técnico de Galaxy General Robotics, predijo que la inteligencia incorporada logrará avances importantes antes de 2028, alcanzando un rendimiento similar al de ChatGPT. Los futuros modelos base entrenados con grandes volúmenes de datos podrían alcanzar una tasa de éxito del 70-80 % en tareas para las que no hayan sido entrenados, gracias a paradigmas avanzados de preentrenamiento y de postentrenamiento eficientes.
En la Conferencia Mundial sobre IA de 2026, Wang He, director técnico de Galaxy General Robotics, predijo que la inteligencia incorporada logrará avances importantes antes de 2028, alcanzando un rendimiento similar al de ChatGPT. Los futuros modelos base entrenados con grandes volúmenes de datos podrían alcanzar una tasa de éxito del 70-80 % en tareas para las que no hayan sido entrenados, gracias a paradigmas avanzados de preentrenamiento y de postentrenamiento eficientes.

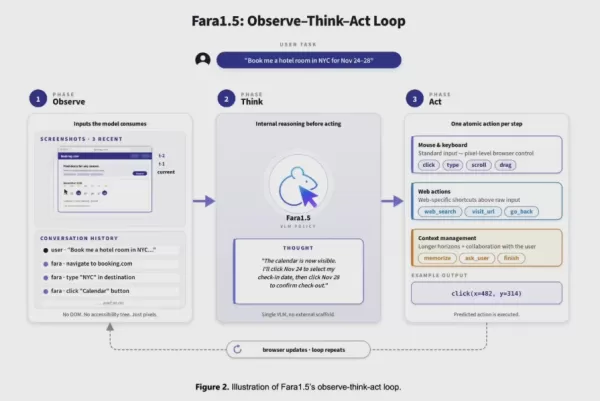
El laboratorio AI Frontiers de Microsoft Research ha lanzado la serie Fara1.5 de modelos de agentes diseñados para la automatización de navegadores. Estos modelos, con escalas de parámetros de hasta 27 000 millones, operan a través del entorno de pruebas MagneticLite utilizando un ciclo de «observar-pensar-actuar» para completar tareas web. En las pruebas comparativas, la versión de 27 000 millones alcanzó una tasa de éxito en las tareas del 72 %, superando a rivales como OpenAI Operator. Los modelos se entrenan con datos diversos e incorporan funciones de seguridad, deteniéndose ante tareas poco claras o problemas de privacidad antes de ejecutar acciones irreversibles.
El laboratorio AI Frontiers de Microsoft Research ha lanzado la serie Fara1.5 de modelos de agentes diseñados para la automatización de navegadores. Estos modelos, con escalas de parámetros de hasta 27 000 millones, operan a través del entorno de pruebas MagneticLite utilizando un ciclo de «observar-pensar-actuar» para completar tareas web. En las pruebas comparativas, la versión de 27 000 millones alcanzó una tasa de éxito en las tareas del 72 %, superando a rivales como OpenAI Operator. Los modelos se entrenan con datos diversos e incorporan funciones de seguridad, deteniéndose ante tareas poco claras o problemas de privacidad antes de ejecutar acciones irreversibles.
OpenAI ha publicado en código abierto su modelo «Privacy Filter», de 150 millones de parámetros, en Hugging Face y GitHub bajo la licencia Apache 2.0. Este modelo, basado en MoE, utiliza la comprensión profunda del lenguaje para anonimizar datos personales en textos, con una puntuación F1 del 97,43 % en las pruebas de referencia, y admite contextos de hasta 128 000 tokens para su implementación local. Contribuye a la protección de la privacidad en los procesos de desarrollo, pero no sustituye a los requisitos de cumplimiento normativo en ámbitos de alta sensibilidad.
OpenAI ha publicado en código abierto su modelo «Privacy Filter», de 150 millones de parámetros, en Hugging Face y GitHub bajo la licencia Apache 2.0. Este modelo, basado en MoE, utiliza la comprensión profunda del lenguaje para anonimizar datos personales en textos, con una puntuación F1 del 97,43 % en las pruebas de referencia, y admite contextos de hasta 128 000 tokens para su implementación local. Contribuye a la protección de la privacidad en los procesos de desarrollo, pero no sustituye a los requisitos de cumplimiento normativo en ámbitos de alta sensibilidad.
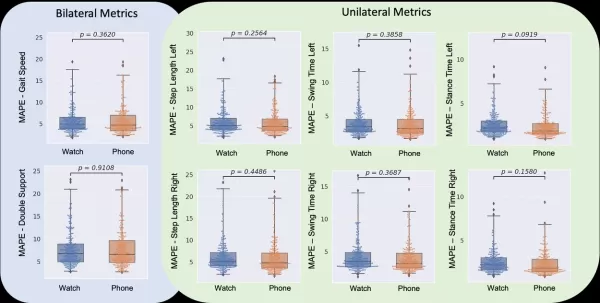
Un estudio de validación a gran escala con 246 participantes reveló que los relojes inteligentes de consumo son una plataforma muy fiable para estimar parámetros clave de la marcha, como la velocidad al caminar y la longitud de los pasos. Mediante un novedoso modelo de aprendizaje profundo, los relojes inteligentes que se llevan en la muñeca alcanzaron una precisión comparable a la de los métodos basados en teléfonos inteligentes. Esto permite realizar análisis prácticos y continuos de la marcha fuera del laboratorio para controlar la salud y evaluar el riesgo de caídas.
Un estudio de validación a gran escala con 246 participantes reveló que los relojes inteligentes de consumo son una plataforma muy fiable para estimar parámetros clave de la marcha, como la velocidad al caminar y la longitud de los pasos. Mediante un novedoso modelo de aprendizaje profundo, los relojes inteligentes que se llevan en la muñeca alcanzaron una precisión comparable a la de los métodos basados en teléfonos inteligentes. Esto permite realizar análisis prácticos y continuos de la marcha fuera del laboratorio para controlar la salud y evaluar el riesgo de caídas.