


 Heim
OpenAI stellt GPT-5.4 Mini und Nano vor – seine leistungsstärksten kleinen Modelle, die fast die Leistung der Vollversion erreichen
OpenAI hat offiziell zwei neue kompakte KI-Modelle vorgestellt: GPT-5.4mini und GPT-5.4nano. Diese Modelle wurden für Anwendungsfälle mit hoher Frequenz und geringer Latenz entwickelt und bieten einen deutlichen Leistungssprung bei gleichzeitig geringem Ressourcenbedarf.
Wichtigste Highlights: Die Balance zwischen geringer Latenz und hoher Effizienz
OpenAI betont, dass die kompakte GPT-5.4-Serie in Szenarien, die außergewöhnlich schnelle Reaktionen erfordern – wie beispielsweise Programmierunterstützung, Screenshot-Analyse und Bildinferenz in Echtzeit –, hervorragende Leistungen erbringt:
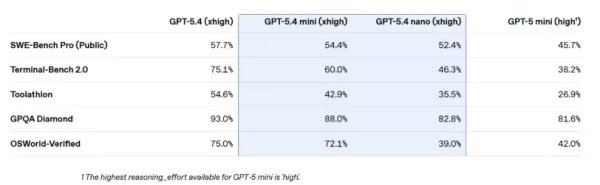
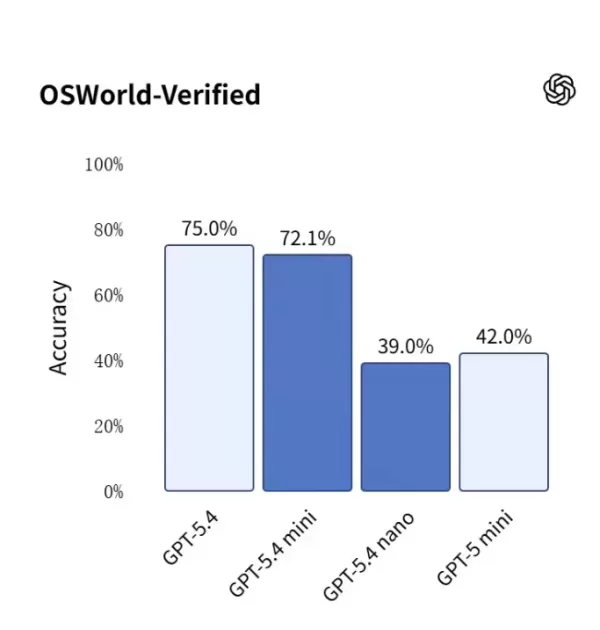
GPT-5.4mini: Es übertrifft frühere Modelle bei der Codegenerierung, dem logischen Schlussfolgern und dem multimodalen Verständnis deutlich und arbeitet mit mehr als doppelter Geschwindigkeit. Seine Ergebnisse in zahlreichen Benchmarks nähern sich denen des viel größeren, voll ausgestatteten GPT-5.4, wodurch es Aufgaben wie komplexe Datenbanknavigation und Front-End-Codegenerierung effizient bewältigen kann.
GPT-5.4nano: Als derzeit kleinste und kostengünstigste Version ist es auf Textklassifizierung, Datenextraktion und einfache Unterstützungsaufgaben zugeschnitten und bietet Entwicklern ein optimales Preis-Leistungs-Verhältnis.
Spezifikationen und Preise
Beide Modelle sind hinsichtlich technischer Spezifikationen und Betriebskosten äußerst wettbewerbsfähig:
GPT-5.4mini: Verfügt über ein extrem langes Kontextfenster von 400.000 Token. Die API-Preise liegen bei 0,75 $ pro Million Eingabetoken und 4,50 $ pro Million Ausgabetoken. Es ist nun vollständig in API, Codex und ChatGPT integriert.
GPT-5.4nano: Derzeit ausschließlich über die API verfügbar, ist der Preis mit nur 0,20 US-Dollar pro Million Eingabetoken und 1,25 US-Dollar pro Million Ausgabetoken äußerst wettbewerbsfähig.
Die Einführung dieser Modelle signalisiert einen Wandel bei KI-Anwendungen weg von einem Fokus auf „skalierende Größe“ hin zu „verbesserter praktischer Effizienz“. Durch ultraschnelle Antwortzeiten bieten sie eine robustere Grundlage für Echtzeit-KI-Interaktionen und die Aufteilung komplexer Arbeitsabläufe.
Verwandter Artikel
 Wan-Streamer v0.2 bietet ultra-niedrige Latenz für KI-Chats
Da sich die moderne Technologie rasch weiterentwickelt, wird die Interaktion zwischen Mensch und KI immer häufiger. Traditionelle Videoanrufe kämpfen oft mit Verzögerungen, Latenzzeiten und einer Synchronisationslücke zwischen Audio und Video. Wan-St
Meta schließt sich TSMC und Micron an, um neue Server mit alter Speicherhardware auszustatten
Während die Einführung künstlicher Intelligenz weltweit voranschreitet, herrscht bei dem nächsten Generation DDR5-Speicher eine kritische Knappheit. Um Verzögerungen beim Aufbau von KI-Rechenzentren zu vermeiden, hat Meta mit Branchenführern wie TSMC
Wie Zeitreihendatenbanken Echtzeit-Robotikdaten ermöglichen
Doug Pagnutti von Tiger Data.Pagnutti fungiert als Industrial Developer Advocate bei Tiger Data und unterstützt Teams beim Aufbau industrieller Systeme in der Praxis.Mit über 12 Jahren Erfahrung in den Bereichen Öl und Gas sowie Fertigungsautomatisie
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
 10 Tools
 xix.ai
Bildung und Lernen
Die besten KI-Nachhilfelehrer für die Prüfungsvorbereitung: Üben Sie Mathematik, Naturwissenschaften und Englisch
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai
Finanzen
KI-Budgetplanungstools für das persönliche Geldmanagement
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
KI-gestützte Schlafüberwachungsassistenten: Verbessern Sie Ihre Erholung durch bessere Gewohnheiten vor dem Schlafengehen
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai
Datenanalyse
KI-gestützte SQL-Copilots für Produkt- und Umsatzanalysen
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai
Bildung und Lernen
Die besten KI-Hausaufgabenhelfer, die wirklich etwas vermitteln: Lerne Konzepte, nicht nur Antworten
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

 Kommentare (1)
![ThomasHernández]()
Finally! Small models that don't sacrifice performance. Will this make AI more accessible for indie devs? 🚀
OpenAI hat offiziell zwei neue kompakte KI-Modelle vorgestellt: GPT-5.4mini und GPT-5.4nano. Diese Modelle wurden für Anwendungsfälle mit hoher Frequenz und geringer Latenz entwickelt und bieten einen deutlichen Leistungssprung bei gleichzeitig geringem Ressourcenbedarf.
Wichtigste Highlights: Die Balance zwischen geringer Latenz und hoher Effizienz
OpenAI betont, dass die kompakte GPT-5.4-Serie in Szenarien, die außergewöhnlich schnelle Reaktionen erfordern – wie beispielsweise Programmierunterstützung, Screenshot-Analyse und Bildinferenz in Echtzeit –, hervorragende Leistungen erbringt:
GPT-5.4mini: Es übertrifft frühere Modelle bei der Codegenerierung, dem logischen Schlussfolgern und dem multimodalen Verständnis deutlich und arbeitet mit mehr als doppelter Geschwindigkeit. Seine Ergebnisse in zahlreichen Benchmarks nähern sich denen des viel größeren, voll ausgestatteten GPT-5.4, wodurch es Aufgaben wie komplexe Datenbanknavigation und Front-End-Codegenerierung effizient bewältigen kann.
GPT-5.4nano: Als derzeit kleinste und kostengünstigste Version ist es auf Textklassifizierung, Datenextraktion und einfache Unterstützungsaufgaben zugeschnitten und bietet Entwicklern ein optimales Preis-Leistungs-Verhältnis.
Spezifikationen und Preise
Beide Modelle sind hinsichtlich technischer Spezifikationen und Betriebskosten äußerst wettbewerbsfähig:
GPT-5.4mini: Verfügt über ein extrem langes Kontextfenster von 400.000 Token. Die API-Preise liegen bei 0,75 $ pro Million Eingabetoken und 4,50 $ pro Million Ausgabetoken. Es ist nun vollständig in API, Codex und ChatGPT integriert.
GPT-5.4nano: Derzeit ausschließlich über die API verfügbar, ist der Preis mit nur 0,20 US-Dollar pro Million Eingabetoken und 1,25 US-Dollar pro Million Ausgabetoken äußerst wettbewerbsfähig.
Die Einführung dieser Modelle signalisiert einen Wandel bei KI-Anwendungen weg von einem Fokus auf „skalierende Größe“ hin zu „verbesserter praktischer Effizienz“. Durch ultraschnelle Antwortzeiten bieten sie eine robustere Grundlage für Echtzeit-KI-Interaktionen und die Aufteilung komplexer Arbeitsabläufe.








 Wan-Streamer v0.2 bietet ultra-niedrige Latenz für KI-Chats
Da sich die moderne Technologie rasch weiterentwickelt, wird die Interaktion zwischen Mensch und KI immer häufiger. Traditionelle Videoanrufe kämpfen oft mit Verzögerungen, Latenzzeiten und einer Synchronisationslücke zwischen Audio und Video. Wan-St
 Meta schließt sich TSMC und Micron an, um neue Server mit alter Speicherhardware auszustatten
Während die Einführung künstlicher Intelligenz weltweit voranschreitet, herrscht bei dem nächsten Generation DDR5-Speicher eine kritische Knappheit. Um Verzögerungen beim Aufbau von KI-Rechenzentren zu vermeiden, hat Meta mit Branchenführern wie TSMC
 Wie Zeitreihendatenbanken Echtzeit-Robotikdaten ermöglichen
Doug Pagnutti von Tiger Data.Pagnutti fungiert als Industrial Developer Advocate bei Tiger Data und unterstützt Teams beim Aufbau industrieller Systeme in der Praxis.Mit über 12 Jahren Erfahrung in den Bereichen Öl und Gas sowie Fertigungsautomatisie

Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai

2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

Finally! Small models that don't sacrifice performance. Will this make AI more accessible for indie devs? 🚀












