


 Heim
Wie können selbstdokumentierende KI-Agenten für die Produktion im Jahr 2025 entwickelt werden?
Viele hoffen zwar, mit KI-Agenten perfekten, produktionsreifen Code zu erstellen, doch die Ergebnisse sind oft fehlerhaft. Der Code kann noch Wochen später fehlerhaft sein, ohne dass klar ersichtlich ist, warum bestimmte Designentscheidungen getroffen wurden. Dieser Artikel befasst sich mit der Erstellung eines selbstdokumentierenden KI-Agenten - eines Agenten, der nicht nur Funktionen bereitstellt, sondern auch die Gründe für seine Entscheidungen darlegt und so dazu beiträgt, Probleme zu lösen, die in der Produktion auftreten, und Ihre Codebasis gesund zu erhalten. Sie finden praktische Schritte und Strategien, um den von KI generierten Code zuverlässiger und wartbarer zu machen und die Kluft zwischen den ursprünglichen Erwartungen und den tatsächlichen Ergebnissen zu überbrücken.
Wichtige Punkte
KI-Agenten können sowohl Code als auch Dokumentation erzeugen, was die langfristige Wartung vereinfacht.
Ein Produktanforderungsdokument (Product Requirement Document, PRD) hilft dabei, KI-generierte Funktionen mit Projektzielen und technischen Anforderungen abzustimmen.
Redis bietet leistungsstarke Vektorsuchfunktionen für effizientes semantisches Caching.
Beim Context-Engineering werden KI-Agenten mit relevanter Dokumentation versorgt, um fundierte Entscheidungen treffen zu können.
Git diff-Befehle helfen den KI-Agenten, Änderungen zwischen Zweigen zu verstehen, und unterstützen so fundierte Architekturentscheidungen.
Erstellen von zuverlässigem und wartbarem KI-generiertem Code
Die Herausforderung bei der Wartung von KI-generierten Funktionen
In der heutigen schnelllebigen Welt der Softwareentwicklung möchte jeder, dass KI fehlerfreien, produktionsreifen Code erzeugt.
Doch die Realität ist oft enttäuschend - der Code versagt noch Wochen später, und die Entwickler können kaum nachvollziehen, warum ein KI-Agent bestimmte Designentscheidungen getroffen hat. Um dies zu überwinden, ist eine Strategie erforderlich, bei der die KI nicht nur Funktionen erstellt, sondern auch ihre Überlegungen erläutert. Diese Methode führt zu zuverlässigeren, leichter zu wartenden Funktionen. Die Lösung liegt in der Selbstdokumentation von KI-Agenten.
Aufbau eines selbstdokumentierenden KI-Agenten
Die Erstellung eines selbstdokumentierenden KI-Agenten umfasst mehrere umsetzbare Schritte, von denen jedes Unternehmen profitieren kann. Diese verbessern die Wartbarkeit und Lesbarkeit der Software und vieles mehr. Im Folgenden finden Sie eine Zusammenfassung, die Ihnen hilft, den Code Ihres Unternehmens zu verbessern:
- Produktanforderungsdokument (PRD): Beginnen Sie mit einem detaillierten PRD.
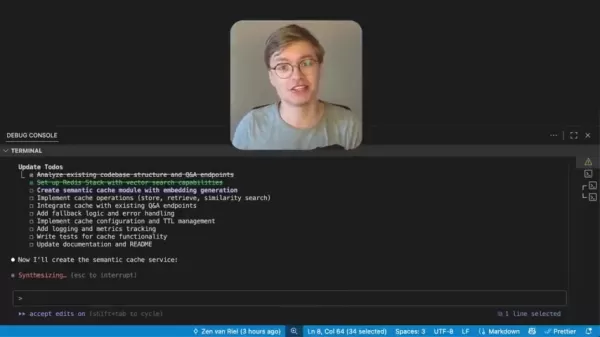
Dieses Dokument dient als Blaupause und beschreibt den Zweck, die Funktionalität und die technischen Spezifikationen der Funktion. Ein klares PRD stellt sicher, dass der KI-Agent einen Code erstellt, der mit den Projektzielen übereinstimmt.
- Semantisches Caching mit Vektorsuchfunktionen: Fügen Sie ein semantisches Caching-Modul für die Embedding-Generierung hinzu. Semantisches Caching identifiziert und speichert ähnliche Fragen und deren Antworten, wodurch Latenzzeiten und Betriebskosten reduziert werden. Die Verwendung von Redis mit Vektorsuche verbessert den Ähnlichkeitsabgleich und macht den Prozess effizienter.
- Kontexterstellung: Statten Sie den KI-Agenten mit der richtigen Dokumentation aus, z. B. mit Leitfäden für die Redis-Vektorsuche und Ihren Q&A-Endpunkten. Dies hilft dem Agenten, den Technologie-Stack zu verstehen und gut begründete Entscheidungen zu treffen.
- Nachverfolgung und Dokumentation von Entscheidungen: Ermöglichen Sie es dem KI-Agenten, seine Entscheidungen während der Entwicklung zu verfolgen und zu dokumentieren. Die Design- und Implementierungsentscheidungen des Agenten werden für die Entwickler sichtbar und lesbar, sodass ein Prüfpfad entsteht, der das "Warum" hinter dem Code erklärt.
Anwendung in der realen Welt: Hinzufügen einer Caching-Funktion zum AI Engineering Tutor
Um diesen Ansatz in Aktion zu sehen, stellen Sie sich vor, Sie fügen Caching zur AI Engineering Tutor-App hinzu.
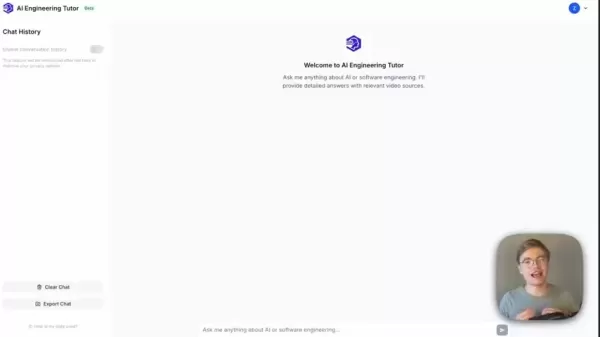
Der AI Engineering Tutor unterstützt das KI-Lernen. Caching beschleunigt die Antworten auf häufige Fragen und verbessert die Benutzerfreundlichkeit. Schnelle Funktionen sind in der heutigen KI-gesteuerten Umgebung besonders wertvoll. Um hier semantisches Caching zu implementieren:
- Abgleich ähnlicher Abfragen mit Vektoreinbettungen.
- Servieren Sie zwischengespeicherte Antworten mit minimaler Verzögerung.
- Verwalten Sie Größe und Dauer des Caches mit TTL- und Kapazitätsgrenzen.
Die Leistungsfähigkeit von Git Diff für KI-Agenten
Nutzung von Git Diff-Befehlen für den Kontext
Es ist wichtig, KI-Agenten den richtigen Kontext zu geben, um architektonische Entscheidungen zu treffen. Git Diff ist ein leistungsstarkes Hilfsmittel.
Durch die Ausführung von git diff main kann der KI-Agent alle Änderungen in einem Zweig überprüfen. So kann er die Entwicklungsarbeit mit dem Produktionszweig vergleichen.
Git diff zeigt, was sich im Vergleich zum aktuellen Produktionscode geändert hat. Dieser Kontext hilft dem Agenten, wichtige Dateien zu lesen und den gesamten Projektumfang zu erfassen, was zu intelligenteren Entscheidungen führt. Der Agent kann dann einen Architektur-Entscheidungsdatensatz erstellen, der detailliert angibt, welche Dateien, Algorithmen und Schwellenwerte im neuesten Build enthalten sind. Dies vereinfacht die Codierungsarbeit und steigert die Produktivität der KI-Ingenieure.
Vermeiden von Fallstricken: Warum das Versprechen "Schneller Code in 5 Sekunden" zu kurz greift
Obwohl KI-generierter Code von manchen als schnelle Lösung angepriesen wird, birgt er Risiken und Unzulänglichkeiten.
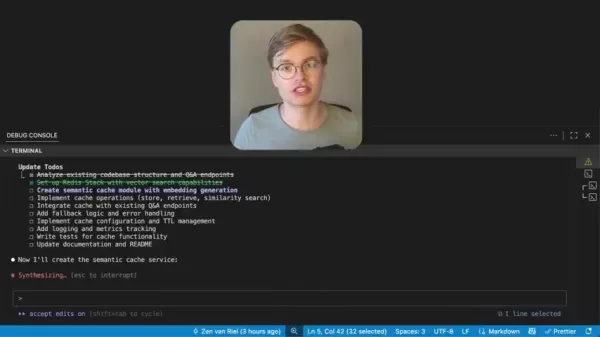
Sich bei übereilten Korrekturen auf KI zu verlassen, führt oft zu weiteren Problemen. Aus diesem Grund sind Qualitätskontrolle und Dokumentation von entscheidender Bedeutung. Planen Sie bei der Entwicklung von KI sorgfältig, um Risiken wie falsche Übereinstimmungen, Speichergrenzen oder veraltete Daten zu vermeiden.
Einige häufige Probleme mit KI-generiertem Code sind:
- Falsche Antworten
- Veraltete Informationen
- Übermäßig strenge Ähnlichkeitsschwellen
- Probleme bei der Cache-Löschung
Sie können diese Risiken reduzieren, indem Sie:
- Einen konservativen Ähnlichkeitsschwellenwert anwenden.
- Regelmäßiges Aktualisieren der im Cache gespeicherten Daten.
- Verwendung einer LRU-Richtlinie mit einem festgelegten Eintragslimit.
Tipps zur Verwendung von KI-gestützten Codesystemen und zur Vermeidung von Kopfschmerzen
Bewährte Kodierungspraktiken
Um das Beste aus KI-gesteuerten Tools herauszuholen und gleichzeitig die Risiken zu minimieren, sollten Sie bestimmte, sorgfältige Praktiken befolgen. Diese Schritte verbessern die Codeleistung und die langfristige Struktur. Beachten Sie diese Empfehlungen:
- Führen Sie Redis über Docker für die lokale Einrichtung aus.
- Verwenden Sie eine .env-Datei, um Umgebungsvariablen sicher zu verwalten.
- Starten Sie Ihr Backend und führen Sie Python-Code aus - dann sind Sie bereit!
Preise für AI-Tools und Funktionen
KI-Werkzeuge
Bei der Auswahl von KI-Entwicklungstools sollten Sie prüfen, welche Funktionen Sie benötigen, wie nachhaltig diese sind und ob der Nutzen die Kosten rechtfertigt. Hier sind einige Optionen:
- AI Engineering Tutor (derzeit in Entwicklung; voraussichtlich zu einem vernünftigen Preis).
- OpenAI API (Text-Einbettung-3-groß).
- FastAPI.
Die Kosten für diese Technologien sind im Allgemeinen niedrig, wenn sie gut gepflegt werden, obwohl eine häufige Nutzung die Kosten erhöhen kann.
Semantisches Caching: Abwägung der Vor- und Nachteile
Vorteile
Verkürzung der Antwortzeit von 2-3 Sekunden auf etwa 100 ms für zwischengespeicherte Inhalte (20-30x schneller).
Senkt die Betriebskosten durch Verringerung des wiederholten LLM und Einbettung von API-Aufrufen.
Verbessert die Benutzerfreundlichkeit durch nahezu sofortige Antworten auf häufig gestellte Fragen.
Reibungslose Integration in bestehende Q&A-Workflows.
Nachteile
Führt eine Infrastruktur-Abhängigkeit ein (Redis Stack).
Kann leicht veraltete Antworten liefern (mit einer TTL von 7 Tagen).
Erhöht die Komplexität der Bereitstellung und Überwachung.
Die Invalidierung des Cache wird schwierig, wenn sich der Inhalt häufig ändert.
Hauptmerkmale von selbstdokumentierenden KI-Agenten
Was zeichnet einen guten selbstdokumentierenden KI-Agenten aus?
Schlüsselelemente definieren einen erfolgreichen selbstdokumentierenden KI-Agenten, insbesondere den SemanticCacheService, der den Kern Ihrer Architektur bilden kann. Effektive semantische Caches beinhalten normalerweise:
- Kern-Caching-Logik mit Redis Stack für die Vektorsuche.
- MNSW-Algorithmus für eine effiziente Ähnlichkeitssuche.
- Einstellbare Ähnlichkeitsschwellenwerte.
- LRU-Evakuierungspolitik mit einer Obergrenze von 500 Einträgen.
- 7-Tage-TTL für Cache-Einträge.
Die Anwendung dieses Multi-Feature-Ansatzes führt zu einem stärkeren, effektiveren KI-System.
Anwendungsfälle für selbstdokumentierende KI-Agenten
Wie kann KI-Dokumentation nützlich sein?
Der Hauptvorteil selbstdokumentierender KI-Agenten ist ihre langfristige Unterstützung für Ihre Projekte. Ein lesbares, nachhaltiges System bietet mehrere Vorteile. Hier sind einige wichtige Anwendungen:
- KI-gestützte Codierungsaufgaben.
- Planung von Software-Architekturen.
- Unterstützung bei der Code-Überprüfung.
- Unterstützung bei technischen Entscheidungen.
FAQ
Warum ist Selbstdokumentation bei KI-Agenten wichtig?
Die Selbstdokumentation stellt sicher, dass die Entwicklungsentscheidungen der KI klar und nachvollziehbar sind, was für die Fehlersuche, die Wartung und die langfristige Zuverlässigkeit des Codes unerlässlich ist.
Welche Rolle spielt ein Produktanforderungsdokument (PRD) bei der KI-Entwicklung?
Ein PRD fungiert als Blaupause, die den KI-Agenten anweist, Funktionen zu entwickeln, die den Projektzielen und technischen Anforderungen entsprechen, um so eine relevante und effektive Leistung zu gewährleisten.
Wie verbessert das Context Engineering die Entscheidungsfindung der KI?
Kontext-Engineering versorgt den KI-Agenten mit der notwendigen Dokumentation und technischen Erkenntnissen, die ihm helfen, die zugrunde liegenden Technologien zu verstehen und fundiertere Entscheidungen zu treffen.
Was sind die Vorteile der Verwendung von Redis mit Vektorsuche für semantisches Caching?
Redis mit Vektorsuche ermöglicht ein effizientes semantisches Caching, indem ähnliche Fragen und Antworten zusammen gespeichert werden, wodurch die Latenzzeit verringert, die Betriebskosten gesenkt und das Benutzererlebnis verbessert wird.
Verwandte Fragen
Wie können Git-Diff-Befehle KI dabei helfen, Codeänderungen zu verstehen?
Mit Git diff können KI-Agenten Änderungen über Zweige hinweg untersuchen, Codeänderungen im Kontext verstehen und Hinzufügungen, Bearbeitungen oder Löschungen identifizieren - und so fundiertere und architektonisch fundierte Entscheidungen treffen.
Verwandter Artikel
 OpenAI verspricht keine Strompreiserhöhungen und einen minimalen Wasserverbrauch für Rechenzentren
Amid wachsendem Widerstand gegen KI-Infrastruktur im gesamten Land wechselt OpenAI zu einer kooperativeren Strategie. Ein Bericht von Business Insider vom 23. Juli zeigt, dass OpenAI aktiv um Unterstützung durch die Gemeinschaft für das Projekt Camel
OpenAI und die Tech-Giganten liefern sich einen Wettstreit um Front-End-Entwickler, da die Nachfrage um über 700 % gestiegen ist
Der jüngste Bericht von Business Insider hebt einen sprunghaften Anstieg der Nachfrage nach Fachkräften mit interdisziplinären praktischen Fähigkeiten im Technologiebereich hervor, der durch die rasan
Wie behebt man Core Web Vitals für bessere SEO-Rankings?
Transformieren Sie Ihren 3D-Workflow mit 3DFY AIEinführungEin neues Zeitalter für 3D-Künstler3DFY AI: Ein großer Schritt nach vornUmwandlung von 2D-Assets in 3D-ModelleVon Text-Prompts zu polierten 3D-AssetsEin optimierter ErstellungsprozessDrei Kern
Empfehlungen zu verwandten Spezialthemen
Schreiben
 AI-Blogtitel-Tools für höhere Klickraten
2026 Neueste Beste Top-Bewertete KI-Blogtitel-Tools für höhere Klickraten! XIX.AI hat sorgfältig eine leistungsstarke, spielfreudige Sammlung der besten Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden einen kostenlosen vs. kostenpflichtigen Vergleich, wöchentlich aktualisierte Rankings und detaillierte Einblicke, die Ihnen helfen, den Traffic Ihres Blogs effizient zu steigern. Besonders empfehlenswerte Optionen sind hervorgehoben, um Ihnen zu helfen, Ihren KI-Vorteil zu entfalten. Entdecken Sie jetzt!
 10 Tools
 xix.ai
Automatisierung
Die besten KI-Tools zur Aufgabenverteilung für Support-Workflows
Die besten und am besten bewerteten KI-Tools für die Aufgabenverteilung in Support-Workflows – Stand 2026! XIX.AI hat eine äußerst leistungsstarke und bahnbrechende Auswahl an Lösungen zusammengestellt, die Sie unbedingt ausprobieren sollten. Alle wurden strengen Praxistests unterzogen und werden wöchentlich aktualisiert. Diese Tools optimieren Arbeitsabläufe, steigern die Produktivität und helfen Teams dabei, einen schnelleren und effizienteren Support zu bieten. Entdecken Sie jetzt das perfekte Tool für Sie und nutzen Sie Ihren KI-Vorteil!
17 Tools
xix.ai
Akademische Forschung
KI-Tools für Literaturangaben und Zusammenfassungen von Fachartikeln
Die besten und am besten bewerteten KI-Tools für Zitate und Zusammenfassungen wissenschaftlicher Artikel im Jahr 2026 – zusammengestellt von XIX.AI. Holen Sie sich leistungsstarke, bahnbrechende Lösungen für die schnelle Erstellung von Inhalten, mehr Effizienz beim Schreiben und eine Steigerung Ihrer Produktivität. Wir bieten einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, damit Sie das Tool finden, das perfekt zu Ihren Anforderungen passt und das Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
10 Tools
xix.ai
Produktivität
Die besten KI-basierten Produktivitätswerkzeuge für die tägliche Arbeit
2026 – Die neuesten, besten und am höchsten bewerteten AI-Produktivitätswerkzeuge für die tägliche Arbeit! XIX.AI hat auf der Grundlage strenger, wöchentlich aktualisierter Ranglisten sowie praktischer Tests eine leistungsstarke Auswahl zusammengestellt, die wirklich etwas verändert. Hier finden Sie Tools, die unbedingt ausprobiert werden sollten, um die Schreibeffizienz zu steigern, die Erstellung von Inhalten zu vereinfachen und Ihnen dabei zu helfen, die Herausforderungen der täglichen Arbeit zu meistern. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante, um das perfekte Werkzeug für Ihre Bedürfnisse zu finden. Entdecken Sie es jetzt und sichern Sie sich einen Wettbewerbsvorteil durch KI!
9 Tools
xix.ai
Akademische Forschung
KI-Tools für systematische Übersichtsarbeiten zur Forschungsauswahl
Die besten und am besten bewerteten Tools für systematische KI-Literaturrecherchen im Jahr 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Lösungen, die strengen Praxistests unterzogen wurden, um präzise Ergebnisse zu liefern. Außerdem bieten wir einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie wöchentlich aktualisierte Rankings, damit Sie die Option finden, die Sie unbedingt ausprobieren sollten und die Ihre Forschungseffizienz deutlich steigert. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil in der akademischen Arbeit!
11 Tools
xix.ai
Design & Kunst
KI-Moodboard-Tools für Marken- und Art-Direction
Die besten KI-Moodboard-Tools 2026 für Marken- und Art-Direction! XIX.AI hat eine Liste der besten leistungsstarken und bahnbrechenden Tools zusammengestellt, mit denen Kreative ihre Produktivität deutlich steigern können. Hier finden Sie detaillierte, wöchentlich aktualisierte Rankings, Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests, die Ihnen bei der Auswahl der perfekten Lösung helfen. Zu den Funktionen, die Sie unbedingt ausprobieren sollten, gehören die sofortige Ideenfindung, nahtlose Zusammenarbeit und optimierte Arbeitsabläufe für all Ihre Designprojekte. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai

 Kommentare (1)
![BenjaminMiller]()
Honestly, the term 'self-documenting' feels like a marketing gimmick until we actually see an AI that can explain why it chose a stupid-looking loop over a vectorized operation. But hey, if it prevents future me from rage-quitting over mysterious production bugs, I'm all for it. 😅
Viele hoffen zwar, mit KI-Agenten perfekten, produktionsreifen Code zu erstellen, doch die Ergebnisse sind oft fehlerhaft. Der Code kann noch Wochen später fehlerhaft sein, ohne dass klar ersichtlich ist, warum bestimmte Designentscheidungen getroffen wurden. Dieser Artikel befasst sich mit der Erstellung eines selbstdokumentierenden KI-Agenten - eines Agenten, der nicht nur Funktionen bereitstellt, sondern auch die Gründe für seine Entscheidungen darlegt und so dazu beiträgt, Probleme zu lösen, die in der Produktion auftreten, und Ihre Codebasis gesund zu erhalten. Sie finden praktische Schritte und Strategien, um den von KI generierten Code zuverlässiger und wartbarer zu machen und die Kluft zwischen den ursprünglichen Erwartungen und den tatsächlichen Ergebnissen zu überbrücken.
Wichtige Punkte
KI-Agenten können sowohl Code als auch Dokumentation erzeugen, was die langfristige Wartung vereinfacht.
Ein Produktanforderungsdokument (Product Requirement Document, PRD) hilft dabei, KI-generierte Funktionen mit Projektzielen und technischen Anforderungen abzustimmen.
Redis bietet leistungsstarke Vektorsuchfunktionen für effizientes semantisches Caching.
Beim Context-Engineering werden KI-Agenten mit relevanter Dokumentation versorgt, um fundierte Entscheidungen treffen zu können.
Git diff-Befehle helfen den KI-Agenten, Änderungen zwischen Zweigen zu verstehen, und unterstützen so fundierte Architekturentscheidungen.
Erstellen von zuverlässigem und wartbarem KI-generiertem Code
Die Herausforderung bei der Wartung von KI-generierten Funktionen
In der heutigen schnelllebigen Welt der Softwareentwicklung möchte jeder, dass KI fehlerfreien, produktionsreifen Code erzeugt.
Doch die Realität ist oft enttäuschend - der Code versagt noch Wochen später, und die Entwickler können kaum nachvollziehen, warum ein KI-Agent bestimmte Designentscheidungen getroffen hat. Um dies zu überwinden, ist eine Strategie erforderlich, bei der die KI nicht nur Funktionen erstellt, sondern auch ihre Überlegungen erläutert. Diese Methode führt zu zuverlässigeren, leichter zu wartenden Funktionen. Die Lösung liegt in der Selbstdokumentation von KI-Agenten.
Aufbau eines selbstdokumentierenden KI-Agenten
Die Erstellung eines selbstdokumentierenden KI-Agenten umfasst mehrere umsetzbare Schritte, von denen jedes Unternehmen profitieren kann. Diese verbessern die Wartbarkeit und Lesbarkeit der Software und vieles mehr. Im Folgenden finden Sie eine Zusammenfassung, die Ihnen hilft, den Code Ihres Unternehmens zu verbessern:
- Produktanforderungsdokument (PRD): Beginnen Sie mit einem detaillierten PRD.
Dieses Dokument dient als Blaupause und beschreibt den Zweck, die Funktionalität und die technischen Spezifikationen der Funktion. Ein klares PRD stellt sicher, dass der KI-Agent einen Code erstellt, der mit den Projektzielen übereinstimmt.
- Semantisches Caching mit Vektorsuchfunktionen: Fügen Sie ein semantisches Caching-Modul für die Embedding-Generierung hinzu. Semantisches Caching identifiziert und speichert ähnliche Fragen und deren Antworten, wodurch Latenzzeiten und Betriebskosten reduziert werden. Die Verwendung von Redis mit Vektorsuche verbessert den Ähnlichkeitsabgleich und macht den Prozess effizienter.
- Kontexterstellung: Statten Sie den KI-Agenten mit der richtigen Dokumentation aus, z. B. mit Leitfäden für die Redis-Vektorsuche und Ihren Q&A-Endpunkten. Dies hilft dem Agenten, den Technologie-Stack zu verstehen und gut begründete Entscheidungen zu treffen.
- Nachverfolgung und Dokumentation von Entscheidungen: Ermöglichen Sie es dem KI-Agenten, seine Entscheidungen während der Entwicklung zu verfolgen und zu dokumentieren. Die Design- und Implementierungsentscheidungen des Agenten werden für die Entwickler sichtbar und lesbar, sodass ein Prüfpfad entsteht, der das "Warum" hinter dem Code erklärt.
Anwendung in der realen Welt: Hinzufügen einer Caching-Funktion zum AI Engineering Tutor
Um diesen Ansatz in Aktion zu sehen, stellen Sie sich vor, Sie fügen Caching zur AI Engineering Tutor-App hinzu.
Der AI Engineering Tutor unterstützt das KI-Lernen. Caching beschleunigt die Antworten auf häufige Fragen und verbessert die Benutzerfreundlichkeit. Schnelle Funktionen sind in der heutigen KI-gesteuerten Umgebung besonders wertvoll. Um hier semantisches Caching zu implementieren:
- Abgleich ähnlicher Abfragen mit Vektoreinbettungen.
- Servieren Sie zwischengespeicherte Antworten mit minimaler Verzögerung.
- Verwalten Sie Größe und Dauer des Caches mit TTL- und Kapazitätsgrenzen.
Die Leistungsfähigkeit von Git Diff für KI-Agenten
Nutzung von Git Diff-Befehlen für den Kontext
Es ist wichtig, KI-Agenten den richtigen Kontext zu geben, um architektonische Entscheidungen zu treffen. Git Diff ist ein leistungsstarkes Hilfsmittel.
Durch die Ausführung von git diff main kann der KI-Agent alle Änderungen in einem Zweig überprüfen. So kann er die Entwicklungsarbeit mit dem Produktionszweig vergleichen.
Git diff zeigt, was sich im Vergleich zum aktuellen Produktionscode geändert hat. Dieser Kontext hilft dem Agenten, wichtige Dateien zu lesen und den gesamten Projektumfang zu erfassen, was zu intelligenteren Entscheidungen führt. Der Agent kann dann einen Architektur-Entscheidungsdatensatz erstellen, der detailliert angibt, welche Dateien, Algorithmen und Schwellenwerte im neuesten Build enthalten sind. Dies vereinfacht die Codierungsarbeit und steigert die Produktivität der KI-Ingenieure.
Vermeiden von Fallstricken: Warum das Versprechen "Schneller Code in 5 Sekunden" zu kurz greift
Obwohl KI-generierter Code von manchen als schnelle Lösung angepriesen wird, birgt er Risiken und Unzulänglichkeiten.
Sich bei übereilten Korrekturen auf KI zu verlassen, führt oft zu weiteren Problemen. Aus diesem Grund sind Qualitätskontrolle und Dokumentation von entscheidender Bedeutung. Planen Sie bei der Entwicklung von KI sorgfältig, um Risiken wie falsche Übereinstimmungen, Speichergrenzen oder veraltete Daten zu vermeiden.
Einige häufige Probleme mit KI-generiertem Code sind:
- Falsche Antworten
- Veraltete Informationen
- Übermäßig strenge Ähnlichkeitsschwellen
- Probleme bei der Cache-Löschung
Sie können diese Risiken reduzieren, indem Sie:
- Einen konservativen Ähnlichkeitsschwellenwert anwenden.
- Regelmäßiges Aktualisieren der im Cache gespeicherten Daten.
- Verwendung einer LRU-Richtlinie mit einem festgelegten Eintragslimit.
Tipps zur Verwendung von KI-gestützten Codesystemen und zur Vermeidung von Kopfschmerzen
Bewährte Kodierungspraktiken
Um das Beste aus KI-gesteuerten Tools herauszuholen und gleichzeitig die Risiken zu minimieren, sollten Sie bestimmte, sorgfältige Praktiken befolgen. Diese Schritte verbessern die Codeleistung und die langfristige Struktur. Beachten Sie diese Empfehlungen:
- Führen Sie Redis über Docker für die lokale Einrichtung aus.
- Verwenden Sie eine .env-Datei, um Umgebungsvariablen sicher zu verwalten.
- Starten Sie Ihr Backend und führen Sie Python-Code aus - dann sind Sie bereit!
Preise für AI-Tools und Funktionen
KI-Werkzeuge
Bei der Auswahl von KI-Entwicklungstools sollten Sie prüfen, welche Funktionen Sie benötigen, wie nachhaltig diese sind und ob der Nutzen die Kosten rechtfertigt. Hier sind einige Optionen:
- AI Engineering Tutor (derzeit in Entwicklung; voraussichtlich zu einem vernünftigen Preis).
- OpenAI API (Text-Einbettung-3-groß).
- FastAPI.
Die Kosten für diese Technologien sind im Allgemeinen niedrig, wenn sie gut gepflegt werden, obwohl eine häufige Nutzung die Kosten erhöhen kann.
Semantisches Caching: Abwägung der Vor- und Nachteile
Vorteile
Verkürzung der Antwortzeit von 2-3 Sekunden auf etwa 100 ms für zwischengespeicherte Inhalte (20-30x schneller).
Senkt die Betriebskosten durch Verringerung des wiederholten LLM und Einbettung von API-Aufrufen.
Verbessert die Benutzerfreundlichkeit durch nahezu sofortige Antworten auf häufig gestellte Fragen.
Reibungslose Integration in bestehende Q&A-Workflows.
Nachteile
Führt eine Infrastruktur-Abhängigkeit ein (Redis Stack).
Kann leicht veraltete Antworten liefern (mit einer TTL von 7 Tagen).
Erhöht die Komplexität der Bereitstellung und Überwachung.
Die Invalidierung des Cache wird schwierig, wenn sich der Inhalt häufig ändert.
Hauptmerkmale von selbstdokumentierenden KI-Agenten
Was zeichnet einen guten selbstdokumentierenden KI-Agenten aus?
Schlüsselelemente definieren einen erfolgreichen selbstdokumentierenden KI-Agenten, insbesondere den SemanticCacheService, der den Kern Ihrer Architektur bilden kann. Effektive semantische Caches beinhalten normalerweise:
- Kern-Caching-Logik mit Redis Stack für die Vektorsuche.
- MNSW-Algorithmus für eine effiziente Ähnlichkeitssuche.
- Einstellbare Ähnlichkeitsschwellenwerte.
- LRU-Evakuierungspolitik mit einer Obergrenze von 500 Einträgen.
- 7-Tage-TTL für Cache-Einträge.
Die Anwendung dieses Multi-Feature-Ansatzes führt zu einem stärkeren, effektiveren KI-System.
Anwendungsfälle für selbstdokumentierende KI-Agenten
Wie kann KI-Dokumentation nützlich sein?
Der Hauptvorteil selbstdokumentierender KI-Agenten ist ihre langfristige Unterstützung für Ihre Projekte. Ein lesbares, nachhaltiges System bietet mehrere Vorteile. Hier sind einige wichtige Anwendungen:
- KI-gestützte Codierungsaufgaben.
- Planung von Software-Architekturen.
- Unterstützung bei der Code-Überprüfung.
- Unterstützung bei technischen Entscheidungen.
FAQ
Warum ist Selbstdokumentation bei KI-Agenten wichtig?
Die Selbstdokumentation stellt sicher, dass die Entwicklungsentscheidungen der KI klar und nachvollziehbar sind, was für die Fehlersuche, die Wartung und die langfristige Zuverlässigkeit des Codes unerlässlich ist.
Welche Rolle spielt ein Produktanforderungsdokument (PRD) bei der KI-Entwicklung?
Ein PRD fungiert als Blaupause, die den KI-Agenten anweist, Funktionen zu entwickeln, die den Projektzielen und technischen Anforderungen entsprechen, um so eine relevante und effektive Leistung zu gewährleisten.
Wie verbessert das Context Engineering die Entscheidungsfindung der KI?
Kontext-Engineering versorgt den KI-Agenten mit der notwendigen Dokumentation und technischen Erkenntnissen, die ihm helfen, die zugrunde liegenden Technologien zu verstehen und fundiertere Entscheidungen zu treffen.
Was sind die Vorteile der Verwendung von Redis mit Vektorsuche für semantisches Caching?
Redis mit Vektorsuche ermöglicht ein effizientes semantisches Caching, indem ähnliche Fragen und Antworten zusammen gespeichert werden, wodurch die Latenzzeit verringert, die Betriebskosten gesenkt und das Benutzererlebnis verbessert wird.
Verwandte Fragen
Wie können Git-Diff-Befehle KI dabei helfen, Codeänderungen zu verstehen?
Mit Git diff können KI-Agenten Änderungen über Zweige hinweg untersuchen, Codeänderungen im Kontext verstehen und Hinzufügungen, Bearbeitungen oder Löschungen identifizieren - und so fundiertere und architektonisch fundierte Entscheidungen treffen.








 OpenAI verspricht keine Strompreiserhöhungen und einen minimalen Wasserverbrauch für Rechenzentren
Amid wachsendem Widerstand gegen KI-Infrastruktur im gesamten Land wechselt OpenAI zu einer kooperativeren Strategie. Ein Bericht von Business Insider vom 23. Juli zeigt, dass OpenAI aktiv um Unterstützung durch die Gemeinschaft für das Projekt Camel
 OpenAI und die Tech-Giganten liefern sich einen Wettstreit um Front-End-Entwickler, da die Nachfrage um über 700 % gestiegen ist
Der jüngste Bericht von Business Insider hebt einen sprunghaften Anstieg der Nachfrage nach Fachkräften mit interdisziplinären praktischen Fähigkeiten im Technologiebereich hervor, der durch die rasan
 Wie behebt man Core Web Vitals für bessere SEO-Rankings?
Transformieren Sie Ihren 3D-Workflow mit 3DFY AIEinführungEin neues Zeitalter für 3D-Künstler3DFY AI: Ein großer Schritt nach vornUmwandlung von 2D-Assets in 3D-ModelleVon Text-Prompts zu polierten 3D-AssetsEin optimierter ErstellungsprozessDrei Kern

2026 Neueste Beste Top-Bewertete KI-Blogtitel-Tools für höhere Klickraten! XIX.AI hat sorgfältig eine leistungsstarke, spielfreudige Sammlung der besten Tools zusammengestellt, die strengen Praxistests unterzogen wurden. Sie finden einen kostenlosen vs. kostenpflichtigen Vergleich, wöchentlich aktualisierte Rankings und detaillierte Einblicke, die Ihnen helfen, den Traffic Ihres Blogs effizient zu steigern. Besonders empfehlenswerte Optionen sind hervorgehoben, um Ihnen zu helfen, Ihren KI-Vorteil zu entfalten. Entdecken Sie jetzt!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für die Aufgabenverteilung in Support-Workflows – Stand 2026! XIX.AI hat eine äußerst leistungsstarke und bahnbrechende Auswahl an Lösungen zusammengestellt, die Sie unbedingt ausprobieren sollten. Alle wurden strengen Praxistests unterzogen und werden wöchentlich aktualisiert. Diese Tools optimieren Arbeitsabläufe, steigern die Produktivität und helfen Teams dabei, einen schnelleren und effizienteren Support zu bieten. Entdecken Sie jetzt das perfekte Tool für Sie und nutzen Sie Ihren KI-Vorteil!
17 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Zitate und Zusammenfassungen wissenschaftlicher Artikel im Jahr 2026 – zusammengestellt von XIX.AI. Holen Sie sich leistungsstarke, bahnbrechende Lösungen für die schnelle Erstellung von Inhalten, mehr Effizienz beim Schreiben und eine Steigerung Ihrer Produktivität. Wir bieten einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, damit Sie das Tool finden, das perfekt zu Ihren Anforderungen passt und das Sie unbedingt ausprobieren sollten. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil.
10 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Produktivitätswerkzeuge für die tägliche Arbeit! XIX.AI hat auf der Grundlage strenger, wöchentlich aktualisierter Ranglisten sowie praktischer Tests eine leistungsstarke Auswahl zusammengestellt, die wirklich etwas verändert. Hier finden Sie Tools, die unbedingt ausprobiert werden sollten, um die Schreibeffizienz zu steigern, die Erstellung von Inhalten zu vereinfachen und Ihnen dabei zu helfen, die Herausforderungen der täglichen Arbeit zu meistern. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante, um das perfekte Werkzeug für Ihre Bedürfnisse zu finden. Entdecken Sie es jetzt und sichern Sie sich einen Wettbewerbsvorteil durch KI!
9 Tools
xix.ai
Die besten und am besten bewerteten Tools für systematische KI-Literaturrecherchen im Jahr 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Lösungen, die strengen Praxistests unterzogen wurden, um präzise Ergebnisse zu liefern. Außerdem bieten wir einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie wöchentlich aktualisierte Rankings, damit Sie die Option finden, die Sie unbedingt ausprobieren sollten und die Ihre Forschungseffizienz deutlich steigert. Entdecken Sie jetzt die Möglichkeiten und sichern Sie sich Ihren KI-Vorteil in der akademischen Arbeit!
11 Tools
xix.ai
Die besten KI-Moodboard-Tools 2026 für Marken- und Art-Direction! XIX.AI hat eine Liste der besten leistungsstarken und bahnbrechenden Tools zusammengestellt, mit denen Kreative ihre Produktivität deutlich steigern können. Hier finden Sie detaillierte, wöchentlich aktualisierte Rankings, Vergleiche zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests, die Ihnen bei der Auswahl der perfekten Lösung helfen. Zu den Funktionen, die Sie unbedingt ausprobieren sollten, gehören die sofortige Ideenfindung, nahtlose Zusammenarbeit und optimierte Arbeitsabläufe für all Ihre Designprojekte. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai

Honestly, the term 'self-documenting' feels like a marketing gimmick until we actually see an AI that can explain why it chose a stupid-looking loop over a vectorized operation. But hey, if it prevents future me from rage-quitting over mysterious production bugs, I'm all for it. 😅












