首页

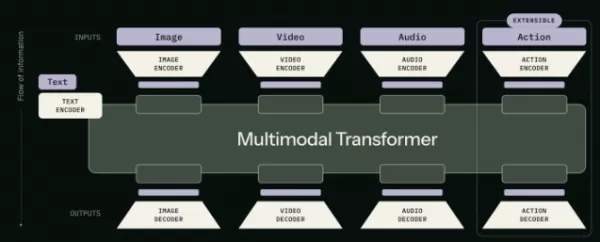
Black Forest Labs 发布了多模态基础模型 FLUX3(目前处于早期访问阶段),该模型通过自监督流框架将图像、视频和音频学习统一起来。它可生成最长 20 秒、带有原生音频的视频,并支持文本转视频、图像转视频等功能。 在基准测试中,FLUX3 面对 Grok Imagine Video 的胜率达到 69%,面对 Seedance 2.0 和 Gemini Omni Flash 的胜率为 52%,并可扩展至机器人行为预测领域。
评论 (0)
0/300