首頁

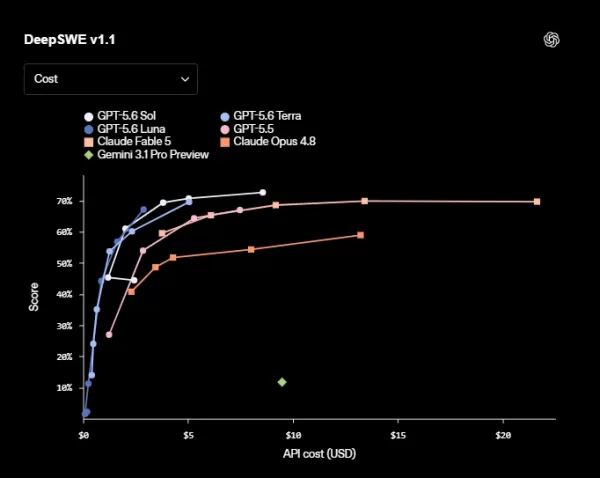
OpenAI 推出了“每美元實用智慧度”這一全新指標,用於衡量超出 Token 成本之外的 AI 實際價值。該指標會從實際輸出效用、每個成功任務的成本、可靠性以及擴充套件性等方面進行評估。其 GPT-5.6 系列模型(Sol、Terra、Luna)也遵循這一評估邏輯,其中 Sol 在 DeepSWE v1.1 測試中的得分達到了 72.7%,同時 API 使用成本還降低了 36.2%。
評論 (0)
0/300