選項
首頁
快訊
內容
SamuelAllen
SamuelAllen
2026-05-27

Stability AI 發布了 Stable Audio 3,這是一款全新的開源音訊生成模型。它採用創新的潛在擴散架構,可生成高品質的立體聲音訊並進行編輯。該模型具備超高速生成能力,僅需 0.62 秒即可生成 20 秒的音訊片段,且效能足夠強大,可在一般消費級硬體上運行。
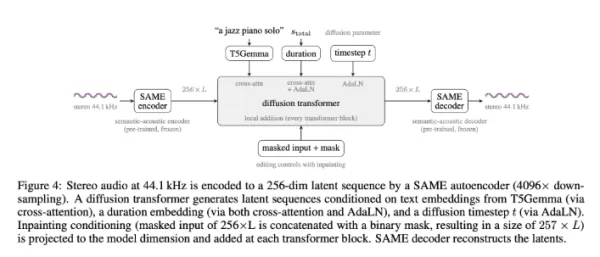
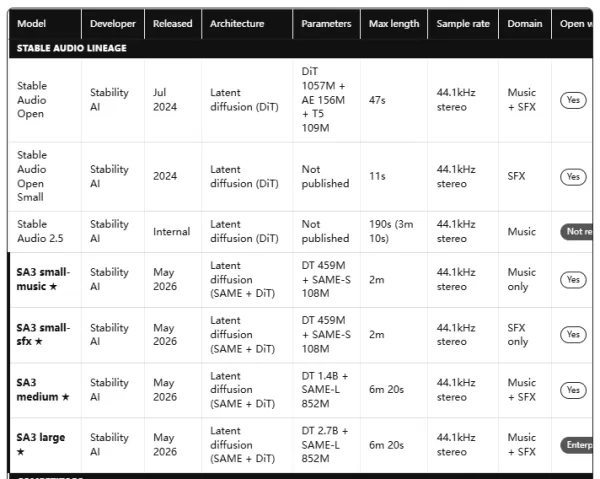
Stability AI 發布了 Stable Audio 3,這是一款全新的開源音訊生成模型。它採用創新的潛在擴散架構,可生成高品質的立體聲音訊並進行編輯。該模型具備超高速生成能力,僅需 0.62 秒即可生成 20 秒的音訊片段,且效能足夠強大,可在一般消費級硬體上運行。 Stability AI 發布了 Stable Audio 3,這是一款全新的開源音訊生成模型。它採用創新的潛在擴散架構,可生成高品質的立體聲音訊並進行編輯。該模型具備超高速生成能力,僅需 0.62 秒即可生成 20 秒的音訊片段,且效能足夠強大,可在一般消費級硬體上運行。
評論 (0)
0/300
OR