首頁

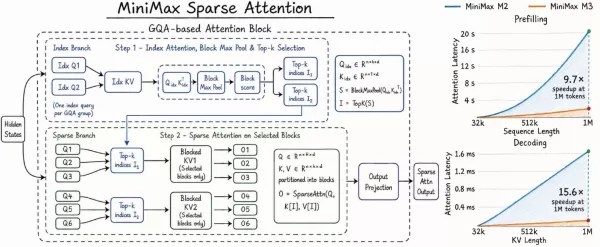
中國人工智慧獨角獸企業 MiniMax 即將推出其全新大型模型 M3,該模型採用創新的稀疏注意力架構。此設計克服了超長上下文情境中的運算瓶頸,能夠高效處理數百萬個標記的上下文。相較於前代產品,M3 在性能上取得顯著提升,預填充速度提高 97 倍,解碼速度提高 156 倍,大幅降低了推論成本。這項突破凸顯了大型模型競爭的重心已從參數規模轉向效率與實用性。
評論 (0)
0/300