


Descubra ferramentas de qualidade de qualidade
Reunir as principais ferramentas de inteligência artificial do mundo para ajudar a melhorar a eficiência do trabalho

Artigos publicados por JerryGonzalez
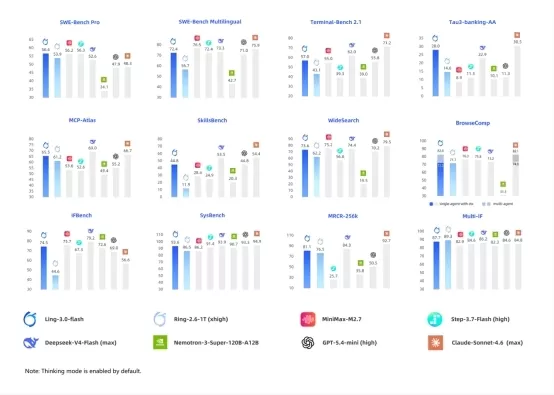
A Ant Bailing lançou o Ling-3.0-Flash, um modelo de raciocínio híbrido com 124 bilhões de parâmetros no total e 5,1 bilhões ativados, capaz de igualar ou superar em desempenho modelos 2 a 3 vezes maiores em tarefas de raciocínio e processamento de textos longos. Ele conta com uma arquitetura de atenção híbrida na proporção de 5:1 (camadas KDA lineares e MLA) e uma taxa de ativação de especialistas de 1/64, o que contribui para maior eficiência. Otimizado para aplicações com agentes, utilizando mais de 10.000 cenários de treinamento, ele reduz o tempo de resposta até o primeiro token em 60 a 80% graças ao armazenamento em cache hierárquico. Está disponível gratuitamente no OpenRouter por uma semana, sendo posteriormente tornado de código aberto.
A Ant Bailing lançou o Ling-3.0-Flash, um modelo de raciocínio híbrido com 124 bilhões de parâmetros no total e 5,1 bilhões ativados, capaz de igualar ou superar em desempenho modelos 2 a 3 vezes maiores em tarefas de raciocínio e processamento de textos longos. Ele conta com uma arquitetura de atenção híbrida na proporção de 5:1 (camadas KDA lineares e MLA) e uma taxa de ativação de especialistas de 1/64, o que contribui para maior eficiência. Otimizado para aplicações com agentes, utilizando mais de 10.000 cenários de treinamento, ele reduz o tempo de resposta até o primeiro token em 60 a 80% graças ao armazenamento em cache hierárquico. Está disponível gratuitamente no OpenRouter por uma semana, sendo posteriormente tornado de código aberto.
A Anthropic expandiu o acesso à pré-visualização do seu modelo grande Mythos para 150 novas instituições, com foco em infraestruturas críticas globais como energia, água e saúde. O modelo detecta vulnerabilidades 10 vezes mais rápido do que os métodos tradicionais e já identificou mais de 10.000 falhas de alto risco para os seus parceiros iniciais. A versão pública está prevista para dentro de algumas semanas.
A Anthropic expandiu o acesso à pré-visualização do seu modelo grande Mythos para 150 novas instituições, com foco em infraestruturas críticas globais como energia, água e saúde. O modelo detecta vulnerabilidades 10 vezes mais rápido do que os métodos tradicionais e já identificou mais de 10.000 falhas de alto risco para os seus parceiros iniciais. A versão pública está prevista para dentro de algumas semanas.

A OpenAI confirmou que seus serviços ChatGPT e API sofreram alta latência em 27 de maio, o que causou respostas lentas. O problema foi largely resolvido no início de 28 de maio, horário de Pequim, embora alguns problemas de desempenho com o Codex e o aplicativo Android Enterprise possam persistir. A empresa afirmou que está monitorando a situação.
A OpenAI confirmou que seus serviços ChatGPT e API sofreram alta latência em 27 de maio, o que causou respostas lentas. O problema foi largely resolvido no início de 28 de maio, horário de Pequim, embora alguns problemas de desempenho com o Codex e o aplicativo Android Enterprise possam persistir. A empresa afirmou que está monitorando a situação.
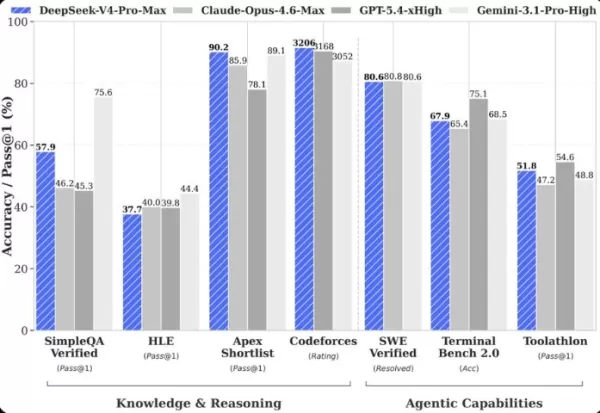
A DeepSeek lança seu modelo de código aberto de última geração, o DeepSeek-V4, com uma janela de contexto de 1 milhão de tokens. O modelo está disponível em duas versões: uma edição Flash leve e uma versão Pro de alto desempenho. O DeepSeek-V4-Pro se destaca em matemática, STEM, programação e capacidades de agente, rivalizando com os principais modelos de código fechado. Ele é oferecido a um preço revolucionário, com custos de entrada tão baixos quanto 1 yuan por milhão de tokens para a versão Flash.
A DeepSeek lança seu modelo de código aberto de última geração, o DeepSeek-V4, com uma janela de contexto de 1 milhão de tokens. O modelo está disponível em duas versões: uma edição Flash leve e uma versão Pro de alto desempenho. O DeepSeek-V4-Pro se destaca em matemática, STEM, programação e capacidades de agente, rivalizando com os principais modelos de código fechado. Ele é oferecido a um preço revolucionário, com custos de entrada tão baixos quanto 1 yuan por milhão de tokens para a versão Flash.
A Moonshot AI, uma “unicórnio” chinesa do setor de IA conhecida por seu modelo de grande escala Kimi, está explorando a possibilidade de uma oferta pública inicial (IPO) em Hong Kong, em negociações preliminares com bancos como o CICC e o Goldman Sachs. Ao mesmo tempo, a empresa busca levantar até US$ 1 bilhão em novos recursos, o que poderia elevar sua avaliação para cerca de US$ 18 bilhões. A iniciativa surge após as listagens bem-sucedidas de concorrentes como a Zhipu e a MiniMax, em um momento em que o setor de IA generativa ganha força.
A Moonshot AI, uma “unicórnio” chinesa do setor de IA conhecida por seu modelo de grande escala Kimi, está explorando a possibilidade de uma oferta pública inicial (IPO) em Hong Kong, em negociações preliminares com bancos como o CICC e o Goldman Sachs. Ao mesmo tempo, a empresa busca levantar até US$ 1 bilhão em novos recursos, o que poderia elevar sua avaliação para cerca de US$ 18 bilhões. A iniciativa surge após as listagens bem-sucedidas de concorrentes como a Zhipu e a MiniMax, em um momento em que o setor de IA generativa ganha força.


