


 Lar

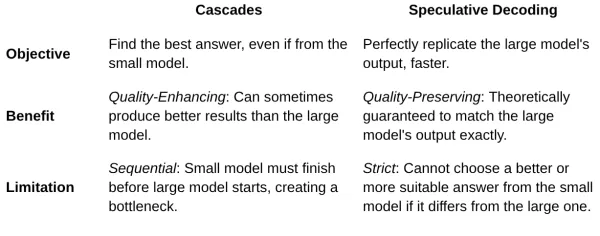
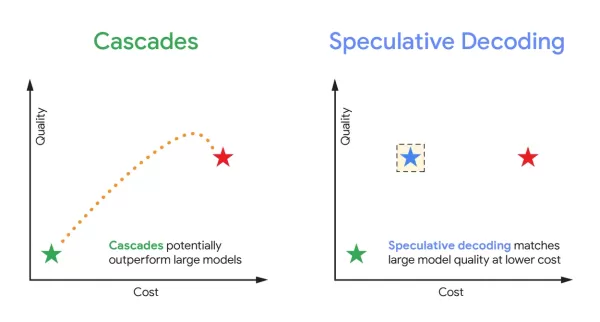
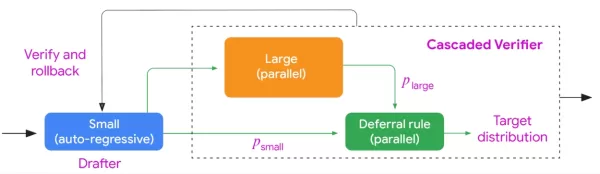
Os pesquisadores propõem "cascatas especulativas", mesclando decodificação especulativa e cascatas padrão para melhorar a eficiência do LLM. O método usa um modelo menor para esboçar saídas e uma regra de adiamento para decidir se aceita ou passa tarefas para um modelo maior. Os testes mostram que ele alcança melhores compensações de velocidade e qualidade do que as técnicas autônomas, otimizando o custo e o desempenho em tarefas como resumo, raciocínio e codificação.
Comentários (0)
0/300






