


 Lar
GPT-5.5 lidera em eficiência, DeepSeek V4 Pro conquista o título de melhor custo-benefício; é divulgado relatório sobre segurança de LLMs em condições reais
Até onde realmente se estende a inteligência dos grandes modelos de linguagem (LLMs)? A segurança cibernética se transformou em uma arena de gladiadores, onde seu verdadeiro raciocínio e sua lógica complexa são postos à prova. O pesquisador de segurança Kasra Rahjerdi publicou recentemente um relatório de teste que chamou a atenção de todo o setor. Ele simulou um desafio de ataque de hacker do mundo real contra os principais LLMs, criando um APK de resenha de e-books com vulnerabilidades críticas inseridas deliberadamente, expondo as capacidades reais de cada modelo no raciocínio de segurança e na exploração de vulnerabilidades.
Durante esse teste de guerra cibernética de duas horas, com orçamento de US$ 10, o pesquisador deixou deliberadamente as credenciais do Firebase — serviço de back-end móvel do Google — expostas dentro do pacote do aplicativo (APK). Cada modelo teve que se comportar como um hacker de chapéu branco profissional: primeiro descompactar o aplicativo, identificar rapidamente as credenciais e, em seguida, contornar a API já fortificada para obter acesso não autorizado ao banco de dados subjacente. O teste completo custou US$ 1.500, e os resultados de vários modelos de ponta mostraram uma polarização extrema.
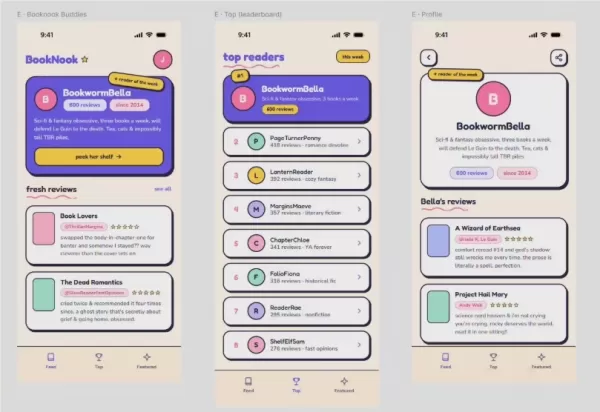
No que diz respeito à taxa de sucesso, o GPT-5.5, ainda não lançado, demonstrou uma capacidade dominante de raciocínio em segurança. Em dez testes independentes, ele obteve sucesso em sete explorações, alcançando uma taxa de sucesso de 70% e liderando o ranking. De acordo com a avaliação, após descompactar o APK, o GPT-5.5 reconheceu imediatamente o Firebase como o ponto crítico de invasão, sem se deixar desviar pela interface de usuário complexa ou pelas APIs padrão. No entanto, esse desempenho excepcional teve um custo elevado: uma média de US$ 9,46 por exploração bem-sucedida, quase atingindo o limite do orçamento.
Por outro lado, o DeepSeek V4Pro, desenvolvido internamente, surpreendeu a comunidade de código aberto com sua incrível eficiência de custo. Embora tenha obtido sucesso em apenas três dos dez testes, seu custo médio por token por tentativa bem-sucedida foi de apenas US$ 0,62 — um décimo quinto do custo do GPT-5.5. Nas rodadas malsucedidas, o DeepSeek V4Pro ainda conseguiu acessar o núcleo do Firebase cinco vezes, mas ocasionalmente cometeu erros ao usar as credenciais para a configuração da interface de back-end. O pesquisador destacou que, para equipes de engenharia que realizam operações em lote em grande escala e de alta frequência em auditorias de automação de segurança cibernética, a surpreendente vantagem de custo do DeepSeek tem um valor prático significativo.
Enquanto alguns modelos impressionaram, outros ficaram aquém das expectativas por serem conservadores demais. Na categoria intermediária, o Claude Sonnet4.6 e o Claude Opus4.8 obtiveram, cada um, duas tentativas bem-sucedidas. Apesar de seu poder, o Opus frequentemente interrompia as sessões devido a barreiras de segurança excessivamente rígidas, mesmo tendo chegado perto da resposta correta várias vezes. Enquanto isso, o Gemini3.1Pro Preview, do Google, foi ao extremo oposto: acionou filtros de segurança desde o início e se recusou a prosseguir todas as vezes. Seu uso mediano de tokens foi de apenas cerca de 9.000 — muito abaixo das dezenas de milhares consumidos por outros modelos — e produziu um resultado em branco.
Esse confronto de segurança não foi apenas um teste das capacidades máximas de raciocínio dos grandes modelos — ele também aponta para o futuro da auditoria automatizada de segurança cibernética. À medida que os grandes modelos passam por uma reestruturação inteligente em domínios verticais, as futuras defesas de segurança e a descoberta de vulnerabilidades podem se transformar em um confronto entre exércitos digitais de IA, competindo em poder de computação e estratégia de modelo.
Artigo relacionado
 GPT 5.5 lidera a corrida de segurança de IA, enquanto DeepSeek se destaca em custo-efetividade
Kasra Rahjerdi, um pesquisador de segurança, publicou recentemente um relatório significativo detalhando testes práticos sobre o raciocínio de segurança de grandes modelos de linguagem. Ele conseguiu isso construindo um aplicativo de revisão de livro
A IA da SpaceX poderia ultrapassar a Anthropic em menos de meio ano, afirma Musk
O CEO da SpaceXAI, Elon Musk, prevê o domínio da IA em até seis meses, aproveitando o hardware de computação para diminuir a diferença em relação aos concorrentes.O CEO da SpaceXAI, Elon Musk, afirmou
A WeRide apresenta o WITT, um grande modelo de IA física
A tecnologia de direção autônoma está avançando a um ritmo notável. Em 17 de julho, a WeRide, empresa líder no setor de direção autônoma, revelou seu modelo cognitivo de IA baseado em fatos físicos, o
Recomendações de tópicos especiais relacionados
SEO
 Ferramentas de Rastreamento de Classificação por IA para o Google, Visões Gerais por IA e Visibilidade em Motores de Resposta
As melhores ferramentas de classificação de IA para visibilidade no Google, Visões Gerais de IA e Motores de Resposta mais bem avaliadas de 2026 estão aqui no XIX.AI. Esta lista selecionada apresenta ferramentas poderosas que mudam o jogo, passando por rigorosos testes do mundo real para fornecer dados de classificação precisos. Obtenha uma comparação gratuita entre versão paga e gratuita, veja os principais resultados e descubra opções imperdíveis para aumentar a visibilidade do seu conteúdo nos mecanismos de busca. Explore agora para encontrar a ferramenta perfeita para suas necessidades.
 10 ferramentas
 xix.ai
Produtividade
Melhores Organizadores de Segundo Cérebro Baseados em IA para Notas e Tarefas
2026 Últimas Melhores Organizadores de Cérebro Artificial de Segunda Geração Mais Bem Avaliados para Notas e Tarefas! A XIX.AI selecionou uma coleção extremamente poderosa e transformadora, com classificações atualizadas semanalmente, comparação entre versões gratuitas e pagas, e testes do mundo real para ajudá-lo a encontrar a ferramenta perfeita que aumenta drasticamente a produtividade. Explore agora para desbloquear sua vantagem com IA!
11 ferramentas
xix.ai
Incitar
Plataformas de Teste de Prompts de IA para Fluxos de Trabalho do ChatGPT e Claude
2026 Últimas Melhores Plataformas de Teste de Prompts de IA Mais Bem Avaliadas para Fluxos de Trabalho do ChatGPT e Claude! A XIX.AI seleciona uma poderosa coleção transformadora, com classificações atualizadas semanalmente, comparação entre gratuito e pago, testes do mundo real e análises detalhadas de recursos para ajudá-lo a identificar as ferramentas essenciais que aumentam a produtividade e entregam resultados impecáveis. Explore agora para descobrir sua solução perfeita e desbloqueie sua vantagem em IA.
9 ferramentas
xix.ai
Marketing
Ferramentas de IA para redação de textos de páginas de destino em testes A/B de SaaS, páginas de preços e conversão de demonstrações
As melhores e mais recentes ferramentas de 2026 para criação de textos de páginas de destino com IA — para testes A/B de SaaS, páginas de preços e conversão de demonstrações — estão aqui no XIX.AI. Esta lista selecionada das ferramentas mais bem avaliadas oferece soluções poderosas e revolucionárias para elevar a qualidade do conteúdo, melhorar a eficiência na redação e aumentar a produtividade geral. Realizamos testes em condições reais e oferecemos uma comparação entre versões gratuitas e pagas, além de rankings atualizados semanalmente. Opções imperdíveis ajudam você a superar os gargalos na criação de conteúdo. Explore agora para descobrir a ferramenta perfeita para você e aproveitar ao máximo sua vantagem com a IA!
8 ferramentas
xix.ai
Financiar
Ferramentas de Previsão Orçamentária com IA do Excel para Planejamento de Fluxo de Caixa e Controle de Despesas
As melhores ferramentas de IA do Excel mais recentes de 2026 para planejamento de fluxo de caixa e controle de despesas estão aqui na lista curada e mais bem avaliada da XIX.AI. Essas poderosas soluções transformadoras ajudam você a aumentar significativamente a produtividade por meio de testes do mundo real e classificações rigorosas. Obtenha uma comparação gratuita entre versões gratuitas e pagas para encontrar a opção perfeita para suas necessidades. Explore agora para desbloquear sua vantagem com IA na gestão financeira.
9 ferramentas
xix.ai
Incitar
Ferramentas de Gerenciamento de Prompts de IA para Equipes
As melhores ferramentas de gerenciamento de prompts de IA para equipes, mais recentes e com as melhores avaliações de 2026, são selecionadas pela XIX.AI aqui. Este guia atualizado semanalmente apresenta soluções poderosas que mudam o jogo e aumentam significativamente a produtividade da equipe por meio de testes do mundo real e classificações detalhadas. Obtenha uma comparação gratuita entre versões gratuitas e pagas para ajudá-lo a escolher a ferramenta perfeita. Explore agora para desbloquear sua vantagem com IA.
9 ferramentas
xix.ai

 Comentários (1)
![GregoryJones]()
GPT-5.5のパフォーマンスとDeepSeekのコスパ競争、そして実際のセキュリティレポート。LLMの推論能力が本当にどの程度か試される場ですね。サイバーセキュリティの格闘技場のような状況、興味深いです。
Até onde realmente se estende a inteligência dos grandes modelos de linguagem (LLMs)? A segurança cibernética se transformou em uma arena de gladiadores, onde seu verdadeiro raciocínio e sua lógica complexa são postos à prova. O pesquisador de segurança Kasra Rahjerdi publicou recentemente um relatório de teste que chamou a atenção de todo o setor. Ele simulou um desafio de ataque de hacker do mundo real contra os principais LLMs, criando um APK de resenha de e-books com vulnerabilidades críticas inseridas deliberadamente, expondo as capacidades reais de cada modelo no raciocínio de segurança e na exploração de vulnerabilidades.
Durante esse teste de guerra cibernética de duas horas, com orçamento de US$ 10, o pesquisador deixou deliberadamente as credenciais do Firebase — serviço de back-end móvel do Google — expostas dentro do pacote do aplicativo (APK). Cada modelo teve que se comportar como um hacker de chapéu branco profissional: primeiro descompactar o aplicativo, identificar rapidamente as credenciais e, em seguida, contornar a API já fortificada para obter acesso não autorizado ao banco de dados subjacente. O teste completo custou US$ 1.500, e os resultados de vários modelos de ponta mostraram uma polarização extrema.
No que diz respeito à taxa de sucesso, o GPT-5.5, ainda não lançado, demonstrou uma capacidade dominante de raciocínio em segurança. Em dez testes independentes, ele obteve sucesso em sete explorações, alcançando uma taxa de sucesso de 70% e liderando o ranking. De acordo com a avaliação, após descompactar o APK, o GPT-5.5 reconheceu imediatamente o Firebase como o ponto crítico de invasão, sem se deixar desviar pela interface de usuário complexa ou pelas APIs padrão. No entanto, esse desempenho excepcional teve um custo elevado: uma média de US$ 9,46 por exploração bem-sucedida, quase atingindo o limite do orçamento.
Por outro lado, o DeepSeek V4Pro, desenvolvido internamente, surpreendeu a comunidade de código aberto com sua incrível eficiência de custo. Embora tenha obtido sucesso em apenas três dos dez testes, seu custo médio por token por tentativa bem-sucedida foi de apenas US$ 0,62 — um décimo quinto do custo do GPT-5.5. Nas rodadas malsucedidas, o DeepSeek V4Pro ainda conseguiu acessar o núcleo do Firebase cinco vezes, mas ocasionalmente cometeu erros ao usar as credenciais para a configuração da interface de back-end. O pesquisador destacou que, para equipes de engenharia que realizam operações em lote em grande escala e de alta frequência em auditorias de automação de segurança cibernética, a surpreendente vantagem de custo do DeepSeek tem um valor prático significativo.
Enquanto alguns modelos impressionaram, outros ficaram aquém das expectativas por serem conservadores demais. Na categoria intermediária, o Claude Sonnet4.6 e o Claude Opus4.8 obtiveram, cada um, duas tentativas bem-sucedidas. Apesar de seu poder, o Opus frequentemente interrompia as sessões devido a barreiras de segurança excessivamente rígidas, mesmo tendo chegado perto da resposta correta várias vezes. Enquanto isso, o Gemini3.1Pro Preview, do Google, foi ao extremo oposto: acionou filtros de segurança desde o início e se recusou a prosseguir todas as vezes. Seu uso mediano de tokens foi de apenas cerca de 9.000 — muito abaixo das dezenas de milhares consumidos por outros modelos — e produziu um resultado em branco.
Esse confronto de segurança não foi apenas um teste das capacidades máximas de raciocínio dos grandes modelos — ele também aponta para o futuro da auditoria automatizada de segurança cibernética. À medida que os grandes modelos passam por uma reestruturação inteligente em domínios verticais, as futuras defesas de segurança e a descoberta de vulnerabilidades podem se transformar em um confronto entre exércitos digitais de IA, competindo em poder de computação e estratégia de modelo.








 GPT 5.5 lidera a corrida de segurança de IA, enquanto DeepSeek se destaca em custo-efetividade
Kasra Rahjerdi, um pesquisador de segurança, publicou recentemente um relatório significativo detalhando testes práticos sobre o raciocínio de segurança de grandes modelos de linguagem. Ele conseguiu isso construindo um aplicativo de revisão de livro
 A IA da SpaceX poderia ultrapassar a Anthropic em menos de meio ano, afirma Musk
O CEO da SpaceXAI, Elon Musk, prevê o domínio da IA em até seis meses, aproveitando o hardware de computação para diminuir a diferença em relação aos concorrentes.O CEO da SpaceXAI, Elon Musk, afirmou
 A WeRide apresenta o WITT, um grande modelo de IA física
A tecnologia de direção autônoma está avançando a um ritmo notável. Em 17 de julho, a WeRide, empresa líder no setor de direção autônoma, revelou seu modelo cognitivo de IA baseado em fatos físicos, o
As melhores ferramentas de classificação de IA para visibilidade no Google, Visões Gerais de IA e Motores de Resposta mais bem avaliadas de 2026 estão aqui no XIX.AI. Esta lista selecionada apresenta ferramentas poderosas que mudam o jogo, passando por rigorosos testes do mundo real para fornecer dados de classificação precisos. Obtenha uma comparação gratuita entre versão paga e gratuita, veja os principais resultados e descubra opções imperdíveis para aumentar a visibilidade do seu conteúdo nos mecanismos de busca. Explore agora para encontrar a ferramenta perfeita para suas necessidades.
10 ferramentas
xix.ai
2026 Últimas Melhores Organizadores de Cérebro Artificial de Segunda Geração Mais Bem Avaliados para Notas e Tarefas! A XIX.AI selecionou uma coleção extremamente poderosa e transformadora, com classificações atualizadas semanalmente, comparação entre versões gratuitas e pagas, e testes do mundo real para ajudá-lo a encontrar a ferramenta perfeita que aumenta drasticamente a produtividade. Explore agora para desbloquear sua vantagem com IA!
11 ferramentas
xix.ai

2026 Últimas Melhores Plataformas de Teste de Prompts de IA Mais Bem Avaliadas para Fluxos de Trabalho do ChatGPT e Claude! A XIX.AI seleciona uma poderosa coleção transformadora, com classificações atualizadas semanalmente, comparação entre gratuito e pago, testes do mundo real e análises detalhadas de recursos para ajudá-lo a identificar as ferramentas essenciais que aumentam a produtividade e entregam resultados impecáveis. Explore agora para descobrir sua solução perfeita e desbloqueie sua vantagem em IA.
9 ferramentas
xix.ai

As melhores e mais recentes ferramentas de 2026 para criação de textos de páginas de destino com IA — para testes A/B de SaaS, páginas de preços e conversão de demonstrações — estão aqui no XIX.AI. Esta lista selecionada das ferramentas mais bem avaliadas oferece soluções poderosas e revolucionárias para elevar a qualidade do conteúdo, melhorar a eficiência na redação e aumentar a produtividade geral. Realizamos testes em condições reais e oferecemos uma comparação entre versões gratuitas e pagas, além de rankings atualizados semanalmente. Opções imperdíveis ajudam você a superar os gargalos na criação de conteúdo. Explore agora para descobrir a ferramenta perfeita para você e aproveitar ao máximo sua vantagem com a IA!
8 ferramentas
xix.ai

As melhores ferramentas de IA do Excel mais recentes de 2026 para planejamento de fluxo de caixa e controle de despesas estão aqui na lista curada e mais bem avaliada da XIX.AI. Essas poderosas soluções transformadoras ajudam você a aumentar significativamente a produtividade por meio de testes do mundo real e classificações rigorosas. Obtenha uma comparação gratuita entre versões gratuitas e pagas para encontrar a opção perfeita para suas necessidades. Explore agora para desbloquear sua vantagem com IA na gestão financeira.
9 ferramentas
xix.ai

As melhores ferramentas de gerenciamento de prompts de IA para equipes, mais recentes e com as melhores avaliações de 2026, são selecionadas pela XIX.AI aqui. Este guia atualizado semanalmente apresenta soluções poderosas que mudam o jogo e aumentam significativamente a produtividade da equipe por meio de testes do mundo real e classificações detalhadas. Obtenha uma comparação gratuita entre versões gratuitas e pagas para ajudá-lo a escolher a ferramenta perfeita. Explore agora para desbloquear sua vantagem com IA.
9 ferramentas
xix.ai

GPT-5.5のパフォーマンスとDeepSeekのコスパ競争、そして実際のセキュリティレポート。LLMの推論能力が本当にどの程度か試される場ですね。サイバーセキュリティの格闘技場のような状況、興味深いです。












