


 家

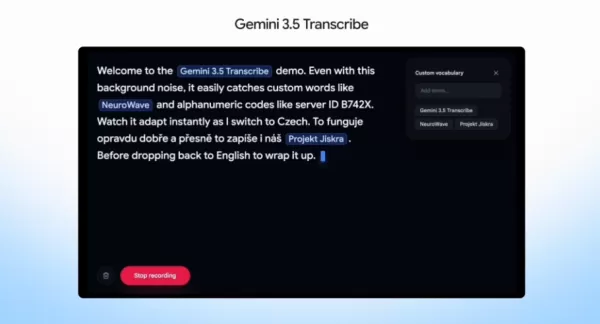
Googleは、同社で最も精度の高い音声認識モデル「Gemini 3.5 Transcribe」をリリースし、開発者やユーザーが利用できるようになりました。このモデルは、非ストリーミング環境において単語誤認率2.6%を達成しており、騒がしい環境や専門用語の多い場面でも優れた性能を発揮します。 主な機能には、ノイズフィルタリング、つなぎ言葉の除去、マルチモデルによるタスクの委譲などが含まれます。85の言語に対応し、話者識別機能も備えており、Android、macOS、Chromeに統合可能です。今回のリリースは、「Gemini 3.7 Flash」やWaymoとの統合と相まって、GoogleのAIエコシステムを強化し、多様なアプリケーション向けに堅牢な音声認識機能を提供します。
コメント (0)
0/300






