家

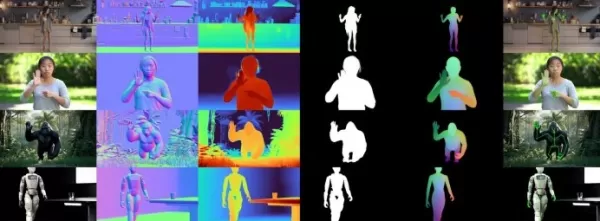
Google DeepMindは、アリババのWan2.1フレームワークを基盤として構築され、動画生成を逆転させて視覚解析エンジンへと変換するモデル「GenCeption」を発表しました。このモデルは、単一のフォワードパス内で、深度推定、セグメンテーション、3D姿勢推定を含む5つの主要タスクを同時に実行します。 わずか7500本の「1人」が登場する合成動画のみで学習されたにもかかわらず、複数の人物、動物、ロボットが登場するシーンにも汎化できる。小型モデルは6秒で81フレームを処理し、140億パラメータの大型モデルは10秒を要するが、猫のひげや毛並みといった微細なディテールも忠実に再現している。
コメント (0)
0/300