


 家
2025年、コミュニケーション・アクセスのための読唇術とは?
コミュニケーションは人間関係の要である。言葉で話すことが最も一般的ですが、多くの人は音声障害のために困難を経験しています。読唇術は、目に見える唇の動きを音声や文字に変換する革新的なソリューションです。コミュニケーションギャップを埋め、話すことに苦労している人々に力を与え、より大きな包括性を育みます。
キーポイント
この技術は、発話に障害のある人の効果的なコミュニケーションを支援する。
AIと機械学習により、唇の動きをテキストや音声に変換する。
ヘルスケア、アクセシビリティ、セキュリティに応用できる。
正確な結果を得るためには、システムのトレーニングが不可欠。
スマートフォンアプリケーションとウェブベースのプラットフォームの両方がこの技術を提供している。
読唇技術を理解する
読唇術とは?
リップリーディング技術は、スピーチリーディングとも呼ばれ、視覚的に音声を理解する方法です。唇、顔、舌の動きを解釈し、話し言葉を解読する。従来、これは難聴者が会話によりよくついていけるように開発した技術だった。今日では、人工知能(AI)と機械学習によって、この技術は強力なテクノロジーへと変貌を遂げた。最新のシステムは、高度なアルゴリズムを使用して、人が話しているビデオを分析し、唇の動きのパターンを識別し、テキストまたは可聴音声に変換する。これにより、話すことが困難な人や音声が利用できない状況でのコミュニケーション補助が可能になる。
コンピュータ・ビジョンと自然言語処理の急速な進歩が、この分野を前進させている。初期のシステムは精度と適応性の問題に直面していたが、最近の改良により、実世界での使用が可能な技術となっている。AIモデルがより洗練され、トレーニングデータセットが増えるにつれて、精度と信頼性は向上し続け、その潜在的な影響力は拡大している。個人の支援からセキュリティの強化まで、読唇技術は私たちのコミュニケーション方法を変えつつある。
読唇技術は、唇以外の文脈や視覚的な手がかりに大きく依存していることを理解することが重要だ。顔の表情、ボディランゲージ、周囲の環境はすべて、正確な解釈に寄与する。話し方のパターン、アクセント、個人のスタイルの違いは、開発者が継続的なアルゴリズムの改良を通じて対処している、さらなる課題を提示します。複数の視覚的・文脈的要素を統合する総合的なアプローチを採用することで、技術はより強固で正確な性能へと進化している。
言語コミュニケーションの意義
言葉によるコミュニケーションは、私たちがアイデアを共有し、感情を表現し、人間関係を構築する主な方法です。話し言葉に依存する世界では、言語コミュニケーションの問題に直面している人は、日常生活でしばしば大きな障壁にぶつかります。このような課題は、以下のような様々な状態から生じる可能性がある:
- 言語障害:失語症、構音障害、吃音などの症状は、言葉を明瞭に表現する能力に影響を与える。
- 喉頭摘出術:喉頭を外科的に摘出することで、言葉を発する身体的能力が失われる。
- 声帯損傷:声帯の損傷や疾患により、発声機能が損なわれたり、消失したりすることがあります。
話すことができなくなると、日常生活でイライラしたり、孤立感を感じたりするようになります。食べ物を注文したり、助けを求めたりするような簡単な仕事が、大きな障害になる。このような状況において、コミュニケーション能力を回復するための橋渡しをする技術が登場しました。
読唇術は重要なライフラインであり、表現と理解の代替手段を提供する。唇の動きをテキストや合成音声に変換することで、会話への完全な参加を可能にし、個人が考えや感情を共有し、つながりを維持することを可能にする。効果的なコミュニケーションは、生活の質を劇的に向上させ、自立、自信、包摂感を促進します。
読唇術アプリケーションを支える技術
中核機能と技術的側面
読唇術アプリケーションは、コンピュータビジョンと人工知能を組み合わせたものです。その中核機能には、いくつかの重要な段階があります:
ビデオの取得:アプリケーションは、スマートフォン、コンピュータのカメラ、またはアップロードされた録画を介して、ユーザーが話しているビデオをキャプチャします。
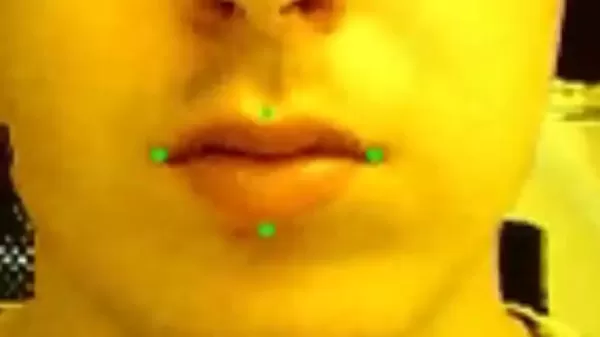
唇の検出と追跡:アルゴリズムがビデオフレーム内の唇の領域を特定・分離し、ユーザーの発話に伴う唇の動きを追跡します。
特徴抽出:唇の形状、角の位置、速度、方向など、唇の動きから関連する特徴を抽出します。高度なAI技術により、基本的なパターンを検出します。
AIによる翻訳:抽出された特徴は、動きを言語出力に翻訳するように訓練されたAIモデルによって処理されます。
出力生成:アプリケーションは、表示されたテキストまたは合成された音声として最終出力を生成します。
これらのアプリケーションの精度は、ビデオの画質、発音の明瞭さ、アルゴリズムの洗練度など、いくつかの要因に左右されます。照明、カメラアングル、個人の話し方もパフォーマンスに影響します。AIモデルを構築するために使用されるトレーニングデータの質と多様性は、改善のために非常に重要である。
開発者たちは、追加的な文脈データを取り入れることで、ロバスト性を継続的に高めている。これには、表情や頭の動きの分析、曖昧な唇の動きを明確にするための音響環境の考慮などが含まれる。これらの高度な技術により、読唇技術はより信頼性が高く、ユーザーフレンドリーなソリューションへと舵を切っている。
読唇アプリケーションの使用
ステップガイド
読唇アプリケーションを使用するには、いくつかの簡単なステップがあります:
- ダウンロードとインストール:ダウンロードとインストール:公式アプリストアからアプリをダウンロードするか、ウェブサイトからアクセスします。
- アカウントのセットアップ(必要な場合):アカウントを作成するか、サービスにログインします。
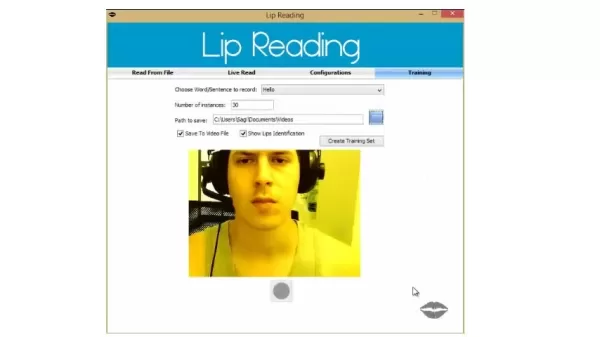
トレーニング(推奨):特定のユーザーに精度を最適化するために、アプリのトレーニング機能をデモのように活用する。
- アプリ内のトレーニング機能を選択します。
- 録音する特定の単語やフレーズを選択します。
- 選択した項目ごとに複数のサンプルを録音する。
- ライブリーディング:ライブ・リーディング・モードを有効にすると、システムが唇の動きをリアルタイムで分析します。
- レビューと解釈:生成されたテキストを確認したり、合成された音声出力を聞くことができます。
読唇術の利点と欠点を比較する
長所
音声障害者のコミュニケーションを可能にする。
難聴者の理解力を高める。
騒がしい環境でのセキュリティ監視を強化する。
多様なコミュニケーションニーズに対する包括性を促進します。
ゲームや音声アシスタントにおける革新的なアプリケーションの基盤として機能します。
短所
視覚的な障害物や話者の違いによって精度が左右される可能性がある。
同音異義語(唇の動きが似ている単語)の区別が難しい。
かなりの計算リソースが必要。
照明条件やカメラアングルによって性能が変化する可能性がある。
正確な解釈のためには、文脈や追加の視覚的手がかりに大きく依存する。
読唇技術の多様な使用例
ヘルスケアとアクセシビリティにおけるコミュニケーションの強化
読唇技術のインパクトは、特にヘルスケアやアクセシビリティなど、さまざまな分野で実用的なメリットをもたらしています。医療分野では、音声障害のある患者が医療スタッフにニーズや症状を伝える際に役立ちます。これは特に喉頭摘出術後や、発話に影響を及ぼす症状に対して価値がある。この技術はまた、健康上の問題を示す可能性のある微妙な変化について、発話パターンをモニターすることもできる。
聴覚障害者にとっては、読唇技術が理解力を高める。騒がしい場所や手話ができないような環境では、ディスカッションを理解し参加するのに役立ちます。補聴器や人工内耳と組み合わせることで、音声知覚をさらに高めることができる。
アクセシビリティに関しては、この技術は、教育、職場、公共スペースにおいて、より包括的な環境を促進する。支援機器やコミュニケーションアプリに統合することで、能力に関係なく効果的な対話が可能になる。また、ビデオやイベントのライブキャプションを容易にし、コンテンツをアクセシブルにする。さらに、読唇術を教えるためのインタラクティブなツールも提供できます。
セキュリティの強化
読唇術は、コミュニケーション支援だけでなく、セキュリティやその他の分野にも応用できる。セキュリティの分野では、空港のような音声監視ができない大音量の環境での会話をモニターし、潜在的な脅威や不審な行動の特定に役立てることができる。法執行機関では、情報収集や容疑者の監視に利用することで、公共の安全を向上させることができる。
その他の潜在的な用途としては、以下のようなものがある:
- 音声アシスタント技術:視覚的な読唇入力を追加することで、騒がしい環境でのアシスタントの精度を向上させる。
- ゲーム:プレイヤーが唇の動きでキャラクターを操作したり、対話したりする没入体験の作成。
- 市場調査:フォーカス・グループにおいて、唇の動きから非言語的な手がかりを読み取ることで、顧客の反応を分析する。
この技術が進化するにつれて、業界を超えた革新的な用途が見つかる可能性が高い。視覚的な合図を意味のある情報に変換するその能力は、コミュニケーション、セキュリティ、人間とコンピューターの相互作用に新たな可能性を開く。
読唇術に関するよくある質問
読唇術の精度はどのくらいですか?
精度は、ビデオの画質、話者の明瞭度、アルゴリズムの洗練度によって異なります。現在のシステムは、理想的な条件下ではそこそこの性能を発揮しますが、照明、角度、個人の話し方などの現実的な要因が結果に影響を与えることがあります。現在進行中の研究では、日常的なシナリオに対する堅牢性の向上に重点を置いています。特定のユーザーの発話パターンでソフトウェアをトレーニングすれば、精度を大幅に向上させることができる。
読唇技術の限界は何ですか?
主な制限は以下のとおりです:話者の顔がはっきり見え、遮るものがないことが必要で、マスクや照明の不足、距離の問題などがあります:アクセント、話し方、顔の解剖学的構造が異なるため、システムのパフォーマンスに影響する:同音異義語:唇の動きが同一または類似している単語(例:「パット」と「バット」)は、文脈がないと区別が難しい:このような課題にもかかわらず、AIとコンピュータビジョンの継続的な進歩により、より信頼性の高いソリューションが着実に生み出されています。
読唇技術は、どのように発話障害のある人の支援に利用できるのでしょうか?
唇の動きをテキストや合成音声に変換することで、代替のコミュニケーションチャネルを提供します。これにより、個人の考えやニーズを効果的に表現することができます。また、会話のキャプションをリアルタイムで生成することもできるため、ユーザーが会話についていけるようになります。支援機器や専用アプリに統合することで、より自立した自信に満ちたコミュニケーションが可能になります。
関連する質問
音声認識技術の最新の進歩は何ですか?
音声認識は、AIと機械学習によって大きく進歩しています。最近の進歩には次のようなものがあります:これらのシステムは音声を直接テキストに書き起こし、プロセスを合理化します:自己教師あり学習:ラベル付けされていない膨大な音声データからモデルを学習し、手作業で注釈を付けたデータセットへの依存を低減します:逆境的トレーニング:バックグラウンドノイズや困難な音声条件に対するモデルのロバスト性を向上させます:多言語認識:多言語を正確に書き起こせるシステムが普及しつつあります。このような進歩により、より正確で弾力性があり、汎用性の高いシステムが構築され、医療や教育からカスタマーサービスまで、さまざまな業界に変革をもたらします。次の表では、従来のアプローチと先進的なアプローチを比較しています。特徴従来の音声認識先進的な音声認識モデル構造音響モデルと言語モデルを分離エンドツーエンドモデル学習データ大規模な注釈付きデータセットが必要自己教師あり学習ノイズロバストネス制限付き教師なし学習言語サポート単一言語多言語サポート
関連記事
 元OpenAIのチーフサイエンティストであるイリヤによるSSIが初のモデルを公開
AIは新たな主要なマイルストーンを達成した。OpenAIを去った後、元チーフサイエンティストのイリヤ・スツケルはSafe Superintelligence Inc.(SSI)を設立し、同社は最近、初代モデルに関する詳細を明らかにした。海外のソーシャルメディアからの報告によれば、チームはTTT(Testing While Training)を活用したコンパクトな推論エンジンを開発中であり、これは安全なスーパーインテリジェンス追求における重要な進展である。この新しいアーキテクチャは、モデルが「学
Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
2026年5月14日、AIアプリケーション開発プラットフォームのLovableは、デンマークのハードウェアスタートアップであるAtechの80万ドルのシード資金調達ラウンドへの参加を発表した。Lovableがリードするこのラウンドには、a16zスカウトファンド、シークイアスカウトファンド、Nordic Makersなど、トップクラスのベンチャーキャピタル企業が参加した。この投資は、Lovableが「Vibeコーディング」の概念を純粋なソフトウェア開発からハードウェアエンジニアリングの領域へと戦略
Anthropic、ClaudeのAIコーディングツールを日本に拡大し、海外成長を促進
Anthropic、米国の主要な人工知能企業は、グローバルな展開を強化している。水曜日、同社は東京で「Code with Claude」と題された大規模な開発者向けイベントを開催し、約500人のソフトウェアエンジニアが集まった。この取り組みは、Claude AIツールおよび関連製品を日本市場に積極的に導入することを目的としており、自律的なコーディング機能による企業生産性の向上という中核的な利点を強調している。自動化されたコード生成への重点本イベントにおいて、Anthropicは複雑なプログラ
関連特集おすすめ
チャットボット
 面接練習用のベストなAI会話トレーニングツール
2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
 12 ツール
 xix.ai
デザインとアート
クリエイティブな実験に最適なAIスタイル転送ツール
2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai
漫画制作
ビジュアルストーリーテリングに最適なAI吹き出しツール
2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai
ミーティングアシスタント
AI会議要約ツールのトップ選定:決定事項とフォローアップを明確に把握
2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai
データ分析
最強のAIデータクリーニングツール:欠損値や重複データを迅速に修正
2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai
デザインとアート
アーティストのための最高のAIクリエイティブアイディエーションツール:ビジュアルブロックを打破する
2026年最新版・最高評価のAIクリエイティブ発想ツールは、XIX.AIによって厳選され、クリエイターが視覚的な壁を打破し、創造性を即座に高めることを支援します。これらの革新的なツールは、実際のテスト結果、無料版と有料版の詳細比較、そして週次更新されるランキングを提供しています。コンテンツ制作を加速し、AIによる優位性を解き放つための最適なツールを見つけてください。今すぐ探索しましょう!
14 ツール
xix.ai

 コメント (1)
0/500
![RogerJackson]()
이 글을 읽으니 생각이 많아지네요. 2025년까지 기술이 여기까지 발전할 거라 예상했나? 다만 개인정보 보호 문제는 여전히 맘에 걸려. 실시간 입술 인식 데이터는 어디에 저장되는 걸까요? 🤔
コミュニケーションは人間関係の要である。言葉で話すことが最も一般的ですが、多くの人は音声障害のために困難を経験しています。読唇術は、目に見える唇の動きを音声や文字に変換する革新的なソリューションです。コミュニケーションギャップを埋め、話すことに苦労している人々に力を与え、より大きな包括性を育みます。
キーポイント
この技術は、発話に障害のある人の効果的なコミュニケーションを支援する。
AIと機械学習により、唇の動きをテキストや音声に変換する。
ヘルスケア、アクセシビリティ、セキュリティに応用できる。
正確な結果を得るためには、システムのトレーニングが不可欠。
スマートフォンアプリケーションとウェブベースのプラットフォームの両方がこの技術を提供している。
読唇技術を理解する
読唇術とは?
リップリーディング技術は、スピーチリーディングとも呼ばれ、視覚的に音声を理解する方法です。唇、顔、舌の動きを解釈し、話し言葉を解読する。従来、これは難聴者が会話によりよくついていけるように開発した技術だった。今日では、人工知能(AI)と機械学習によって、この技術は強力なテクノロジーへと変貌を遂げた。最新のシステムは、高度なアルゴリズムを使用して、人が話しているビデオを分析し、唇の動きのパターンを識別し、テキストまたは可聴音声に変換する。これにより、話すことが困難な人や音声が利用できない状況でのコミュニケーション補助が可能になる。
コンピュータ・ビジョンと自然言語処理の急速な進歩が、この分野を前進させている。初期のシステムは精度と適応性の問題に直面していたが、最近の改良により、実世界での使用が可能な技術となっている。AIモデルがより洗練され、トレーニングデータセットが増えるにつれて、精度と信頼性は向上し続け、その潜在的な影響力は拡大している。個人の支援からセキュリティの強化まで、読唇技術は私たちのコミュニケーション方法を変えつつある。
読唇技術は、唇以外の文脈や視覚的な手がかりに大きく依存していることを理解することが重要だ。顔の表情、ボディランゲージ、周囲の環境はすべて、正確な解釈に寄与する。話し方のパターン、アクセント、個人のスタイルの違いは、開発者が継続的なアルゴリズムの改良を通じて対処している、さらなる課題を提示します。複数の視覚的・文脈的要素を統合する総合的なアプローチを採用することで、技術はより強固で正確な性能へと進化している。
言語コミュニケーションの意義
言葉によるコミュニケーションは、私たちがアイデアを共有し、感情を表現し、人間関係を構築する主な方法です。話し言葉に依存する世界では、言語コミュニケーションの問題に直面している人は、日常生活でしばしば大きな障壁にぶつかります。このような課題は、以下のような様々な状態から生じる可能性がある:
- 言語障害:失語症、構音障害、吃音などの症状は、言葉を明瞭に表現する能力に影響を与える。
- 喉頭摘出術:喉頭を外科的に摘出することで、言葉を発する身体的能力が失われる。
- 声帯損傷:声帯の損傷や疾患により、発声機能が損なわれたり、消失したりすることがあります。
話すことができなくなると、日常生活でイライラしたり、孤立感を感じたりするようになります。食べ物を注文したり、助けを求めたりするような簡単な仕事が、大きな障害になる。このような状況において、コミュニケーション能力を回復するための橋渡しをする技術が登場しました。
読唇術は重要なライフラインであり、表現と理解の代替手段を提供する。唇の動きをテキストや合成音声に変換することで、会話への完全な参加を可能にし、個人が考えや感情を共有し、つながりを維持することを可能にする。効果的なコミュニケーションは、生活の質を劇的に向上させ、自立、自信、包摂感を促進します。
読唇術アプリケーションを支える技術
中核機能と技術的側面
読唇術アプリケーションは、コンピュータビジョンと人工知能を組み合わせたものです。その中核機能には、いくつかの重要な段階があります:
ビデオの取得:アプリケーションは、スマートフォン、コンピュータのカメラ、またはアップロードされた録画を介して、ユーザーが話しているビデオをキャプチャします。
唇の検出と追跡:アルゴリズムがビデオフレーム内の唇の領域を特定・分離し、ユーザーの発話に伴う唇の動きを追跡します。
特徴抽出:唇の形状、角の位置、速度、方向など、唇の動きから関連する特徴を抽出します。高度なAI技術により、基本的なパターンを検出します。
AIによる翻訳:抽出された特徴は、動きを言語出力に翻訳するように訓練されたAIモデルによって処理されます。
出力生成:アプリケーションは、表示されたテキストまたは合成された音声として最終出力を生成します。
これらのアプリケーションの精度は、ビデオの画質、発音の明瞭さ、アルゴリズムの洗練度など、いくつかの要因に左右されます。照明、カメラアングル、個人の話し方もパフォーマンスに影響します。AIモデルを構築するために使用されるトレーニングデータの質と多様性は、改善のために非常に重要である。
開発者たちは、追加的な文脈データを取り入れることで、ロバスト性を継続的に高めている。これには、表情や頭の動きの分析、曖昧な唇の動きを明確にするための音響環境の考慮などが含まれる。これらの高度な技術により、読唇技術はより信頼性が高く、ユーザーフレンドリーなソリューションへと舵を切っている。
読唇アプリケーションの使用
ステップガイド
読唇アプリケーションを使用するには、いくつかの簡単なステップがあります:
- ダウンロードとインストール:ダウンロードとインストール:公式アプリストアからアプリをダウンロードするか、ウェブサイトからアクセスします。
- アカウントのセットアップ(必要な場合):アカウントを作成するか、サービスにログインします。
トレーニング(推奨):特定のユーザーに精度を最適化するために、アプリのトレーニング機能をデモのように活用する。
- アプリ内のトレーニング機能を選択します。
- 録音する特定の単語やフレーズを選択します。
- 選択した項目ごとに複数のサンプルを録音する。
- ライブリーディング:ライブ・リーディング・モードを有効にすると、システムが唇の動きをリアルタイムで分析します。
- レビューと解釈:生成されたテキストを確認したり、合成された音声出力を聞くことができます。
読唇術の利点と欠点を比較する
長所
音声障害者のコミュニケーションを可能にする。
難聴者の理解力を高める。
騒がしい環境でのセキュリティ監視を強化する。
多様なコミュニケーションニーズに対する包括性を促進します。
ゲームや音声アシスタントにおける革新的なアプリケーションの基盤として機能します。
短所
視覚的な障害物や話者の違いによって精度が左右される可能性がある。
同音異義語(唇の動きが似ている単語)の区別が難しい。
かなりの計算リソースが必要。
照明条件やカメラアングルによって性能が変化する可能性がある。
正確な解釈のためには、文脈や追加の視覚的手がかりに大きく依存する。
読唇技術の多様な使用例
ヘルスケアとアクセシビリティにおけるコミュニケーションの強化
読唇技術のインパクトは、特にヘルスケアやアクセシビリティなど、さまざまな分野で実用的なメリットをもたらしています。医療分野では、音声障害のある患者が医療スタッフにニーズや症状を伝える際に役立ちます。これは特に喉頭摘出術後や、発話に影響を及ぼす症状に対して価値がある。この技術はまた、健康上の問題を示す可能性のある微妙な変化について、発話パターンをモニターすることもできる。
聴覚障害者にとっては、読唇技術が理解力を高める。騒がしい場所や手話ができないような環境では、ディスカッションを理解し参加するのに役立ちます。補聴器や人工内耳と組み合わせることで、音声知覚をさらに高めることができる。
アクセシビリティに関しては、この技術は、教育、職場、公共スペースにおいて、より包括的な環境を促進する。支援機器やコミュニケーションアプリに統合することで、能力に関係なく効果的な対話が可能になる。また、ビデオやイベントのライブキャプションを容易にし、コンテンツをアクセシブルにする。さらに、読唇術を教えるためのインタラクティブなツールも提供できます。
セキュリティの強化
読唇術は、コミュニケーション支援だけでなく、セキュリティやその他の分野にも応用できる。セキュリティの分野では、空港のような音声監視ができない大音量の環境での会話をモニターし、潜在的な脅威や不審な行動の特定に役立てることができる。法執行機関では、情報収集や容疑者の監視に利用することで、公共の安全を向上させることができる。
その他の潜在的な用途としては、以下のようなものがある:
- 音声アシスタント技術:視覚的な読唇入力を追加することで、騒がしい環境でのアシスタントの精度を向上させる。
- ゲーム:プレイヤーが唇の動きでキャラクターを操作したり、対話したりする没入体験の作成。
- 市場調査:フォーカス・グループにおいて、唇の動きから非言語的な手がかりを読み取ることで、顧客の反応を分析する。
この技術が進化するにつれて、業界を超えた革新的な用途が見つかる可能性が高い。視覚的な合図を意味のある情報に変換するその能力は、コミュニケーション、セキュリティ、人間とコンピューターの相互作用に新たな可能性を開く。
読唇術に関するよくある質問
読唇術の精度はどのくらいですか?
精度は、ビデオの画質、話者の明瞭度、アルゴリズムの洗練度によって異なります。現在のシステムは、理想的な条件下ではそこそこの性能を発揮しますが、照明、角度、個人の話し方などの現実的な要因が結果に影響を与えることがあります。現在進行中の研究では、日常的なシナリオに対する堅牢性の向上に重点を置いています。特定のユーザーの発話パターンでソフトウェアをトレーニングすれば、精度を大幅に向上させることができる。
読唇技術の限界は何ですか?
主な制限は以下のとおりです:話者の顔がはっきり見え、遮るものがないことが必要で、マスクや照明の不足、距離の問題などがあります:アクセント、話し方、顔の解剖学的構造が異なるため、システムのパフォーマンスに影響する:同音異義語:唇の動きが同一または類似している単語(例:「パット」と「バット」)は、文脈がないと区別が難しい:このような課題にもかかわらず、AIとコンピュータビジョンの継続的な進歩により、より信頼性の高いソリューションが着実に生み出されています。
読唇技術は、どのように発話障害のある人の支援に利用できるのでしょうか?
唇の動きをテキストや合成音声に変換することで、代替のコミュニケーションチャネルを提供します。これにより、個人の考えやニーズを効果的に表現することができます。また、会話のキャプションをリアルタイムで生成することもできるため、ユーザーが会話についていけるようになります。支援機器や専用アプリに統合することで、より自立した自信に満ちたコミュニケーションが可能になります。
関連する質問
音声認識技術の最新の進歩は何ですか?
音声認識は、AIと機械学習によって大きく進歩しています。最近の進歩には次のようなものがあります:これらのシステムは音声を直接テキストに書き起こし、プロセスを合理化します:自己教師あり学習:ラベル付けされていない膨大な音声データからモデルを学習し、手作業で注釈を付けたデータセットへの依存を低減します:逆境的トレーニング:バックグラウンドノイズや困難な音声条件に対するモデルのロバスト性を向上させます:多言語認識:多言語を正確に書き起こせるシステムが普及しつつあります。このような進歩により、より正確で弾力性があり、汎用性の高いシステムが構築され、医療や教育からカスタマーサービスまで、さまざまな業界に変革をもたらします。次の表では、従来のアプローチと先進的なアプローチを比較しています。特徴従来の音声認識先進的な音声認識モデル構造音響モデルと言語モデルを分離エンドツーエンドモデル学習データ大規模な注釈付きデータセットが必要自己教師あり学習ノイズロバストネス制限付き教師なし学習言語サポート単一言語多言語サポート








 元OpenAIのチーフサイエンティストであるイリヤによるSSIが初のモデルを公開
AIは新たな主要なマイルストーンを達成した。OpenAIを去った後、元チーフサイエンティストのイリヤ・スツケルはSafe Superintelligence Inc.(SSI)を設立し、同社は最近、初代モデルに関する詳細を明らかにした。海外のソーシャルメディアからの報告によれば、チームはTTT(Testing While Training)を活用したコンパクトな推論エンジンを開発中であり、これは安全なスーパーインテリジェンス追求における重要な進展である。この新しいアーキテクチャは、モデルが「学
 Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
2026年5月14日、AIアプリケーション開発プラットフォームのLovableは、デンマークのハードウェアスタートアップであるAtechの80万ドルのシード資金調達ラウンドへの参加を発表した。Lovableがリードするこのラウンドには、a16zスカウトファンド、シークイアスカウトファンド、Nordic Makersなど、トップクラスのベンチャーキャピタル企業が参加した。この投資は、Lovableが「Vibeコーディング」の概念を純粋なソフトウェア開発からハードウェアエンジニアリングの領域へと戦略
 Anthropic、ClaudeのAIコーディングツールを日本に拡大し、海外成長を促進
Anthropic、米国の主要な人工知能企業は、グローバルな展開を強化している。水曜日、同社は東京で「Code with Claude」と題された大規模な開発者向けイベントを開催し、約500人のソフトウェアエンジニアが集まった。この取り組みは、Claude AIツールおよび関連製品を日本市場に積極的に導入することを目的としており、自律的なコーディング機能による企業生産性の向上という中核的な利点を強調している。自動化されたコード生成への重点本イベントにおいて、Anthropicは複雑なプログラ

2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai

2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai

2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai

2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai

2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai

2026年最新版・最高評価のAIクリエイティブ発想ツールは、XIX.AIによって厳選され、クリエイターが視覚的な壁を打破し、創造性を即座に高めることを支援します。これらの革新的なツールは、実際のテスト結果、無料版と有料版の詳細比較、そして週次更新されるランキングを提供しています。コンテンツ制作を加速し、AIによる優位性を解き放つための最適なツールを見つけてください。今すぐ探索しましょう!
14 ツール
xix.ai

이 글을 읽으니 생각이 많아지네요. 2025년까지 기술이 여기까지 발전할 거라 예상했나? 다만 개인정보 보호 문제는 여전히 맘에 걸려. 실시간 입술 인식 데이터는 어디에 저장되는 걸까요? 🤔












