Hogar

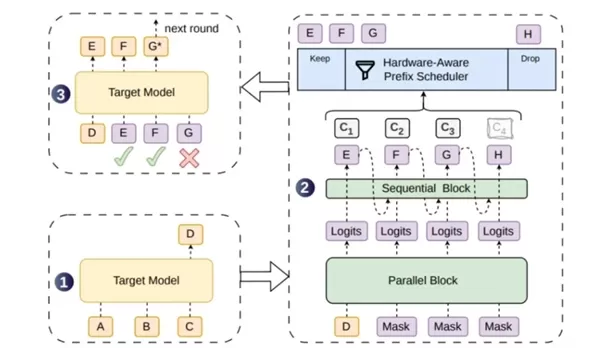
La Universidad de Pekín y DeepSeek han publicado en código abierto DSpark, un marco de trabajo para la aceleración de la inferencia en modelos de lenguaje de gran tamaño. Utiliza una arquitectura semiautorregresiva y una programación basada en la confianza para reducir la latencia y el desperdicio de recursos computacionales en escenarios de alta concurrencia. Las pruebas demuestran que DSpark supera a Eagle3 y DFlash, especialmente en tareas con secuencias largas. Implementado en DeepSeek-V4, el código completo está disponible en GitHub.
comentario (0)
0/300