


 Hogar
Microsoft publica en código abierto Phi-4-Vision, un modelo ligero de IA multimodal
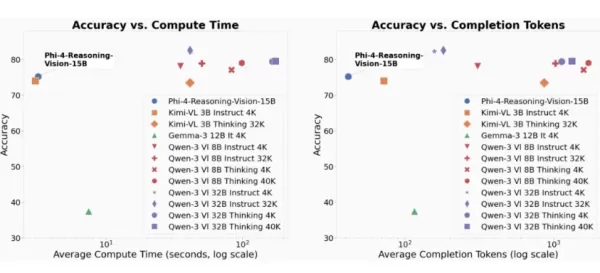
Microsoft ha publicado oficialmente en código abierto su último modelo de razonamiento multimodal, Phi-4-reasoning-vision-15B. Con 15 000 millones de parámetros, este modelo logra un equilibrio ideal entre alto rendimiento y bajo coste. Su arquitectura ligera lo convierte en una nueva opción muy interesante para abordar tareas visuales complejas en entornos con recursos limitados.
Una «potencia compacta» impulsada por datos refinados
A diferencia de los modelos típicos del sector, entrenados con billones de tokens, Phi-4-reasoning-vision se desarrolló utilizando solo 200 000 millones de tokens multimodales. El equipo dio prioridad a la calidad de los datos mediante una rigurosa limpieza de los datos de código abierto, la generación de datos sintéticos específicos y la calibración cuidadosa de las proporciones de datos específicos del dominio, como el aumento del contenido matemático para potenciar el razonamiento computacional. Este enfoque permite un rendimiento excelente en el razonamiento científico y en las tareas de localización de elementos en pantalla.
Estrategia innovadora de razonamiento híbrido
Una innovación clave de este modelo es su diseño de «vía de razonamiento híbrida»:
Tareas de percepción: para tareas sencillas como la subtitulación de imágenes o el OCR, el modelo utiliza por defecto un modo de respuesta directa, optimizado para la velocidad y una menor latencia.
Tareas de razonamiento: cuando se enfrenta a una lógica compleja, como la interpretación de fórmulas matemáticas o gráficos científicos, activa automáticamente un proceso estructurado de cadena de pensamiento (CoT) para garantizar la precisión de la respuesta.
Los usuarios también pueden cambiar manualmente entre estos dos modos utilizando frases de activación específicas, adaptando el comportamiento del modelo a las diferentes necesidades de la aplicación.
Al integrar el codificador de resolución dinámica SigLIP-2, el modelo destaca en la percepción de detalles finos dentro de capturas de pantalla de alta resolución. Esta capacidad lo posiciona como una base ideal para desarrollar Agentes de Uso Informático (CUA), que pueden identificar con precisión e interactuar con botones, campos y otros elementos en interfaces digitales.
Phi-4-reasoning-vision-15B ya está disponible en las principales plataformas de código abierto. Microsoft prevé que este modelo compacto demostrará cómo «más pequeño y más rápido» también puede significar «más capaz» en el ámbito multimodal, lo que contribuirá a impulsar la adopción de la inteligencia espacial y las tecnologías interactivas en tiempo real.
Artículo relacionado
 Vals, respaldado por Andreessen, apunta al liderazgo en evaluación de benchmarks de IA
El benchmarking se ha convertido en el estándar de la industria para que las empresas de inteligencia artificial validen las capacidades de sus modelos, aprovechen métricas favorables para diferenciarse de la competencia y comercialicen su superiorid
El ejecutivo de Apple, John Ternus, afirma que el iPhone es el mejor dispositivo con inteligencia artificial
El próximo director ejecutivo de Apple, John Ternus, aclaró la estrategia de inteligencia artificial de la compañía durante el evento Sorpresa y Brillo del miércoles, afirmando que el iPhone ya es el dispositivo de IA principal y priorizando la priva
Qwen-Audio-3.0-TTS: El modelo de síntesis de voz a gran escala de Qwen reduce la demora del primer paquete a 300 ms
La competencia en tecnología de voz entre los principales desarrolladores de inteligencia artificial se ha intensificado con una nueva incorporación. El 20 de julio, Qwen lanzó su último modelo de síntesis de audio, Qwen-Audio-3.0-TTS, desplazando el
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (1)
0/500
![StevenSanchez]()
So Microsoft just dropped Phi-4-Vision as open source? That's a bold move — 15B params and low cost sounds like a sweet spot for startups who can't afford GPT-4. But I wonder: will this actually drive real multimodal apps or just end up as another benchmark-chasing experiment?
Microsoft ha publicado oficialmente en código abierto su último modelo de razonamiento multimodal, Phi-4-reasoning-vision-15B. Con 15 000 millones de parámetros, este modelo logra un equilibrio ideal entre alto rendimiento y bajo coste. Su arquitectura ligera lo convierte en una nueva opción muy interesante para abordar tareas visuales complejas en entornos con recursos limitados.
Una «potencia compacta» impulsada por datos refinados
A diferencia de los modelos típicos del sector, entrenados con billones de tokens, Phi-4-reasoning-vision se desarrolló utilizando solo 200 000 millones de tokens multimodales. El equipo dio prioridad a la calidad de los datos mediante una rigurosa limpieza de los datos de código abierto, la generación de datos sintéticos específicos y la calibración cuidadosa de las proporciones de datos específicos del dominio, como el aumento del contenido matemático para potenciar el razonamiento computacional. Este enfoque permite un rendimiento excelente en el razonamiento científico y en las tareas de localización de elementos en pantalla.
Estrategia innovadora de razonamiento híbrido
Una innovación clave de este modelo es su diseño de «vía de razonamiento híbrida»:
Tareas de percepción: para tareas sencillas como la subtitulación de imágenes o el OCR, el modelo utiliza por defecto un modo de respuesta directa, optimizado para la velocidad y una menor latencia.
Tareas de razonamiento: cuando se enfrenta a una lógica compleja, como la interpretación de fórmulas matemáticas o gráficos científicos, activa automáticamente un proceso estructurado de cadena de pensamiento (CoT) para garantizar la precisión de la respuesta.
Los usuarios también pueden cambiar manualmente entre estos dos modos utilizando frases de activación específicas, adaptando el comportamiento del modelo a las diferentes necesidades de la aplicación.
Al integrar el codificador de resolución dinámica SigLIP-2, el modelo destaca en la percepción de detalles finos dentro de capturas de pantalla de alta resolución. Esta capacidad lo posiciona como una base ideal para desarrollar Agentes de Uso Informático (CUA), que pueden identificar con precisión e interactuar con botones, campos y otros elementos en interfaces digitales.
Phi-4-reasoning-vision-15B ya está disponible en las principales plataformas de código abierto. Microsoft prevé que este modelo compacto demostrará cómo «más pequeño y más rápido» también puede significar «más capaz» en el ámbito multimodal, lo que contribuirá a impulsar la adopción de la inteligencia espacial y las tecnologías interactivas en tiempo real.








 Vals, respaldado por Andreessen, apunta al liderazgo en evaluación de benchmarks de IA
El benchmarking se ha convertido en el estándar de la industria para que las empresas de inteligencia artificial validen las capacidades de sus modelos, aprovechen métricas favorables para diferenciarse de la competencia y comercialicen su superiorid
 El ejecutivo de Apple, John Ternus, afirma que el iPhone es el mejor dispositivo con inteligencia artificial
El próximo director ejecutivo de Apple, John Ternus, aclaró la estrategia de inteligencia artificial de la compañía durante el evento Sorpresa y Brillo del miércoles, afirmando que el iPhone ya es el dispositivo de IA principal y priorizando la priva
 Qwen-Audio-3.0-TTS: El modelo de síntesis de voz a gran escala de Qwen reduce la demora del primer paquete a 300 ms
La competencia en tecnología de voz entre los principales desarrolladores de inteligencia artificial se ha intensificado con una nueva incorporación. El 20 de julio, Qwen lanzó su último modelo de síntesis de audio, Qwen-Audio-3.0-TTS, desplazando el

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

So Microsoft just dropped Phi-4-Vision as open source? That's a bold move — 15B params and low cost sounds like a sweet spot for startups who can't afford GPT-4. But I wonder: will this actually drive real multimodal apps or just end up as another benchmark-chasing experiment?












