


 Hogar
M6 Intelligence y Tsinghua lanzan BitCPM-CANN, un proyecto de código abierto para ejecutar modelos de gran tamaño en dispositivos móviles
MBLab, en colaboración con la Universidad de Tsinghua y la comunidad de código abierto OpenBMB, ha presentado recientemente y ha publicado en código abierto un importante avance en el entrenamiento de modelos grandes con bajo número de bits: BitCPM-CANN. Desarrollado de forma nativa en la plataforma Ascend de Huawei, este hito supone un avance en la optimización y el despliegue técnico de modelos grandes de IA en el borde de la red.
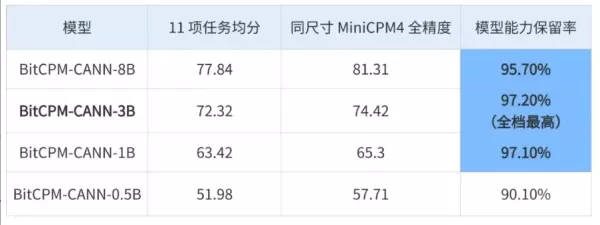
Una ventaja de memoria seis veces mayor rompe las barreras del hardware
BitCPM-CANN, ahora de código abierto, está disponible en cuatro tamaños: 0,5B, 1B, 3B y 8B. En comparaciones directas con modelos de precisión completa de tamaño equivalente, ofrece un rendimiento excepcional. En comparación con la precisión convencional BF16, logra un ahorro de memoria aproximadamente seis veces mayor durante la inferencia, lo que reduce drásticamente el hardware necesario para ejecutar modelos de gran tamaño.
En el caso de los dispositivos móviles, esta ventaja de seis veces en memoria significa que los modelos grandes de 8B de parámetros —que antes requerían hardware de gama alta— ahora pueden ejecutarse sin problemas en los principales smartphones de gama alta. Este notable margen de memoria acelera directamente la adopción y el despliegue comercial de la tecnología de IA en el borde en plataformas móviles.
La alta tasa de retención valida la reproducibilidad de la ingeniería
A pesar de la reducción del tamaño del modelo, BitCPM-CANN conserva un rendimiento excepcionalmente alto, con tasas de retención de la capacidad que oscilan entre el 90 % y el 97,2 %. En el caso de los tres modelos de mayor tamaño, las tasas de retención se sitúan entre el 95,7 % y el 97,2 %, mientras que incluso la variante más pequeña, de 0,5 mil millones, supera el 90 %.
Estos impresionantes resultados demuestran de forma sistemática que el enfoque de entrenamiento de bajo número de bits ofrece una gran escalabilidad y reproducibilidad de la ingeniería. MBLab ha establecido una base integral para el entrenamiento de bajo número de bits utilizando estas tecnologías fundamentales, que abarca toda la pila de ingeniería —incluida la adaptación al entorno, la compatibilidad con secuencias largas de 32K y los operadores fusionados—, proporcionando así una infraestructura pública robusta para futuros trabajos de entrenamiento de bajo número de bits en la plataforma Ascend.
Artículo relacionado
 Apple acepta un acuerdo de 250 millones de dólares por la demora en el lanzamiento de Siri con inteligencia artificial
Apple ha acordado pagar 250 millones de dólares para resolver una demanda colectiva sobre su marketing de funciones de inteligencia artificial antes del lanzamiento del iPhone 16, según informó por primera vez el Financial Times.La demanda afirmaba
Ando lanza una aplicación de mensajería para equipos que une la colaboración humana y la inteligencia artificial
En 2025, mientras Sara Du ayudaba a empresas a desarrollar servidores MCP, surgió una pregunta recurrente: ¿cómo podrían los equipos aprovechar agentes de IA directamente dentro de Slack? El camino estaba obstaculizado por importantes barreras técnic
Empirik, respaldada por Sequoia, recauda 21 millones de dólares para predecir las interrupciones antes de que ocurran
Antes de unirse a Sequoia Capital en 2020 como director digital y de información, Avon Puri pasó más de una década dirigiendo la infraestructura en Rubrik y VMware. Hace tres años, cuando los modelos de lenguaje grandes comenzaron a mostrar su verdad
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
MBLab, en colaboración con la Universidad de Tsinghua y la comunidad de código abierto OpenBMB, ha presentado recientemente y ha publicado en código abierto un importante avance en el entrenamiento de modelos grandes con bajo número de bits: BitCPM-CANN. Desarrollado de forma nativa en la plataforma Ascend de Huawei, este hito supone un avance en la optimización y el despliegue técnico de modelos grandes de IA en el borde de la red.
Una ventaja de memoria seis veces mayor rompe las barreras del hardware
BitCPM-CANN, ahora de código abierto, está disponible en cuatro tamaños: 0,5B, 1B, 3B y 8B. En comparaciones directas con modelos de precisión completa de tamaño equivalente, ofrece un rendimiento excepcional. En comparación con la precisión convencional BF16, logra un ahorro de memoria aproximadamente seis veces mayor durante la inferencia, lo que reduce drásticamente el hardware necesario para ejecutar modelos de gran tamaño.
En el caso de los dispositivos móviles, esta ventaja de seis veces en memoria significa que los modelos grandes de 8B de parámetros —que antes requerían hardware de gama alta— ahora pueden ejecutarse sin problemas en los principales smartphones de gama alta. Este notable margen de memoria acelera directamente la adopción y el despliegue comercial de la tecnología de IA en el borde en plataformas móviles.
La alta tasa de retención valida la reproducibilidad de la ingeniería
A pesar de la reducción del tamaño del modelo, BitCPM-CANN conserva un rendimiento excepcionalmente alto, con tasas de retención de la capacidad que oscilan entre el 90 % y el 97,2 %. En el caso de los tres modelos de mayor tamaño, las tasas de retención se sitúan entre el 95,7 % y el 97,2 %, mientras que incluso la variante más pequeña, de 0,5 mil millones, supera el 90 %.
Estos impresionantes resultados demuestran de forma sistemática que el enfoque de entrenamiento de bajo número de bits ofrece una gran escalabilidad y reproducibilidad de la ingeniería. MBLab ha establecido una base integral para el entrenamiento de bajo número de bits utilizando estas tecnologías fundamentales, que abarca toda la pila de ingeniería —incluida la adaptación al entorno, la compatibilidad con secuencias largas de 32K y los operadores fusionados—, proporcionando así una infraestructura pública robusta para futuros trabajos de entrenamiento de bajo número de bits en la plataforma Ascend.








 Apple acepta un acuerdo de 250 millones de dólares por la demora en el lanzamiento de Siri con inteligencia artificial
Apple ha acordado pagar 250 millones de dólares para resolver una demanda colectiva sobre su marketing de funciones de inteligencia artificial antes del lanzamiento del iPhone 16, según informó por primera vez el Financial Times.La demanda afirmaba
 Ando lanza una aplicación de mensajería para equipos que une la colaboración humana y la inteligencia artificial
En 2025, mientras Sara Du ayudaba a empresas a desarrollar servidores MCP, surgió una pregunta recurrente: ¿cómo podrían los equipos aprovechar agentes de IA directamente dentro de Slack? El camino estaba obstaculizado por importantes barreras técnic
 Empirik, respaldada por Sequoia, recauda 21 millones de dólares para predecir las interrupciones antes de que ocurran
Antes de unirse a Sequoia Capital en 2020 como director digital y de información, Avon Puri pasó más de una década dirigiendo la infraestructura en Rubrik y VMware. Hace tres años, cuando los modelos de lenguaje grandes comenzaron a mostrar su verdad

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












