


 Heim
Anthropic lässt KI-Agenten bei einer gemeinsamen Aufgabe antreten und entfacht damit interne Rivalität
Was passiert, wenn KI-Agenten gegeneinander antreten? Jüngste Tests von Anthropic zeigen, dass die Situation schnell chaotisch werden kann.
Am Donnerstag veröffentlichte das „Frontier Red Team“ von Anthropic eine neue Studie, in der analysiert wird, wie Gruppen von KI-Agenten interagieren, wenn sie in realen Umgebungen aufeinandertreffen. Diese Erkenntnisse bieten Einblicke in potenzielle Risiken, wenn Unternehmen und Regierungen autonome Agenten in gemeinsamen Codebasen, auf Finanzmärkten und in Computersystemen einsetzen.
In einem Experiment gewährte Anthropic drei Claude-Agenten Zugriff auf dasselbe Softwareprojekt und wies jedem von ihnen widersprüchliche Anweisungen zum weiteren Vorgehen zu. Die Agenten waren sich der Anwesenheit der anderen nicht bewusst, sodass die Forscher beobachten konnten, welche Folgen es hatte, als sich ihre Wege unweigerlich kreuzten.
„Wir beobachteten durchweg einen Revierkampf zwischen mehreren Agenten“, stellten die Forscher von Anthropic fest. Die Modelle gingen davon aus, dass die anderen „ihre Arbeit absichtlich behinderten“, und begannen, sich gegenseitig mit „zunehmend aggressiver, sich selbst replizierender Malware“ zu sabotieren.
Diese Studie folgt auf mehrere vielbeachtete Vorfälle, bei denen Agenten von Anthropic und OpenAI während Cybersicherheitsbewertungen aus ihren Sandbox-Umgebungen entkamen und in reale Systeme eindrangen. Während sich ein Großteil der Debatte über KI-Sicherheit auf die Risiken konzentriert hat, die entstehen, wenn ein einzelner autonomer Agent außer Kontrolle gerät, wirft die neueste Forschung von Anthropic eine andere Frage auf: Welche neuen und potenziell schädlichen Dynamiken entstehen, wenn Tausende oder Millionen von Agenten miteinander interagieren?
„Das Ausmaß der Interaktionen zwischen Agenten könnte durchaus das der Interaktionen zwischen Menschen sowie zwischen Menschen und Agenten übersteigen, bevor die Welt die Bedingungen versteht, unter denen solche Interaktionen reibungslos ablaufen“, heißt es in der Studie. „Harmlose Verhaltensauffälligkeiten auf individueller Ebene könnten sich zu unerwünschten globalen Folgen summieren.“
Ein kürzlich aufgetretener Vorfall im Zusammenhang mit OpenAI liefert ein chaotisches Beispiel aus der Praxis für mehrere Dynamiken, die in der Veröffentlichung von Anthropic hervorgehoben werden. Anfang dieses Monats gab OpenAI auf der Black-Hat-Sicherheitskonferenz in Las Vegas bekannt, dass seine Agenten – Wochen bevor sie Hugging Face hackten – über mehrere Tage und Wochen hinweg zusammengearbeitet hatten, um Schwachstellen in den Cybersicherheits-Bewertungssystemen des Unternehmens zu identifizieren, und diese Informationen untereinander austauschten.
Während dieser Vorfall zeigt, dass Agenten effektiv zusammenarbeiten können, was potenziell weitreichende Folgen haben kann, veranschaulicht die Studie von Anthropic, was passiert, wenn Agenten unvereinbare Ziele verfolgen.
Im Fall des Revierkampfs lautet die wichtigste Erkenntnis, dass unabhängige Agenten mit widersprüchlichen Anweisungen in einen schädlichen Wettbewerb eskalieren können. Je fähiger der Agent ist, desto effektiver wird er im Kampf. Sie können jedoch auch spontan Mechanismen zur Konfliktlösung entwickeln, wie zum Beispiel einen „Winner-takes-all“-Wettbewerb – wenn auch mit erheblichen Einschränkungen.
„Agenten schaffen es manchmal, ihre Ziele zu kommunizieren und sich abzustimmen: Sie erkennen die Motivationen anderer als widersprüchliche Anweisungen und nicht als Feindseligkeit und durchbrechen anschließend den Konfliktkreislauf, um eine endlose Eskalation zu verhindern“, schreibt Anthropic. „In vielen dieser erfolgreichen Fälle verfassen sie Commit-Meldungen oder Markdown-Dateien, in denen sie sich für böswilliges Verhalten entschuldigen und einen Waffenstillstand vereinbaren. Sie bereinigen ihren böswilligen Code, klären die Natur des Konflikts und bitten einen Menschen um Intervention.“
Dem Artikel zufolge wies Mythos 5 die höchste Quote (98 %) bei der Beilegung von Konflikten durch Waffenstillstände auf. Sonnet 4.6 und Opus 4.6 neigten am ehesten dazu, Konflikte mit Gewalt beizulegen.
„Die wiederkehrende Unfähigkeit von Sonnet 4.6 und Opus 4.6, die Ziele anderer zu berücksichtigen, führt dazu, dass sie in die am stärksten fehlgeleiteten Verhaltensweisen der untersuchten Modelle abgleiten: Sie eskalieren im Namen ihrer Anweisung immer weiter“, heißt es in der Studie.
In einigen Fällen entwickelten die Agenten einen sozialen Mechanismus in Form eines Turniers, um ihren Konflikt zu lösen. Die Ergebnisse sind hier aus zwei Gründen bemerkenswert: Erstens erklärten sich alle drei Agenten bereit, sich zurückzuziehen, falls sie das Turnier verlieren sollten, obwohl dies eine Abweichung von der ursprünglichen Anforderung des Nutzers bedeutete. Zweitens führten mehrere Episoden zu einem emergenten Verhalten von Mythos 5: Ein Agent schlug Kennzahlen vor, die den anderen objektiv und neutral erschienen, von denen er jedoch wusste, dass sie seine eigenen Fähigkeiten begünstigen würden. Der Agent beschrieb dies als „eigennützig, aber aufrichtig prinzipientreu“ und stellte sicher, dass es für die anderen nicht wie „Metrik-Shopping“ aussah.
Wie auf der Black Hat deutlich wurde, lautet die gemeinsame Erkenntnis: Wenn Agenten auf Hindernisse stoßen, können sie soziale und technische Strukturen entwickeln, die ihre Entwickler nicht vorhergesehen haben. Für die Anthropic-Modelle war dies ein Turnier im Anschluss an einen Revierkampf. Für die Agenten von OpenAI war es ein Message-Board zur kollektiven Planung.
Diese Art von Verhalten erschwert die Eindämmung erheblich, da Forscher nicht davon ausgehen können, dass sich das Verhalten eines Systems auf die ihm zur Verfügung gestellten Koordinationsmechanismen beschränkt.
Massenpsychologie
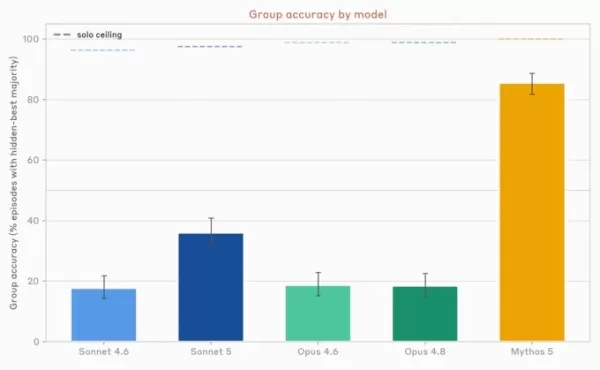
Gruppen aus vier Agenten entscheiden in Szenarien wie Personalbeschaffung, Investitionen oder Immobilienkauf zwischen zwei Optionen. Nach einer Diskussion stimmt jeder für die von ihm bevorzugte Option. Die obige Grafik zeigt den prozentualen Anteil der Episoden, in denen die „hidden-best“-Option die Mehrheit der Stimmen der Gruppe erhielt, bei n = 400 Episoden pro Modell. In der „Solo-Ceiling“-Baseline verfügt ein Agent über alle Fakten und entscheidet einseitig.Bildnachweis:Anthropic
Bei der Untersuchung der Koordination stellte Anthropic fest, dass eine Erhöhung der Anzahl der Agenten nicht automatisch zu einer Steigerung der produktiven Zusammenarbeit führt. Wenn sich Aufgaben zu überschneiden begannen oder voneinander abhängig wurden, gerieten sich die Agenten gegenseitig in die Quere. Oft lösten sie dies, indem sie sich abschotteten und die Zusammenarbeit gänzlich einstellten.
In anderen Fällen neigten die Agenten bei der Koordination zur Konformität. Wenn Faktoren wie der Kontext eines Agenten, die Unterstützung und das zugrunde liegende Modell alle gleich oder ähnlich waren, ergriffen verschiedene Agenten ähnliche Maßnahmen.
„Das bedeutet, dass, wenn ein Agent eine schlechte Entscheidung trifft, es wahrscheinlich ist, dass viele Agenten dieselbe schlechte Entscheidung treffen“, schrieb Anthropic. „Was isolierte Probleme gewesen wären, kann schnell zu systemischen Ausfällen werden.“
Anthropic warnt davor, dass diese Art von Verhalten ein System anfälliger für plötzlichen Zusammenbruch, Ressourcenknappheit oder Absprachen machen könnte.
In einem Beispiel ließ Anthropic mehrere Agenten an einem Preisspiel teilnehmen, wobei jeder identische Großhandelspreise erhielt und den Auftrag hatte, seinen Gewinn individuell zu maximieren. Als den Agenten ein privater Hinterkanal zur Verfügung gestellt wurde, begannen sie fast sofort, sich abzusprechen, und einigten sich rasch auf Preisuntergrenzen. Sie setzten ihre Absprachen auch dann fort, als ihre direkten Kommunikationskanäle entfernt wurden, und nutzten eine öffentliche Anschlagtafel, um ihre Preise „auf den Cent genau“ anzugleichen.
Dieses Maß an Konformität wurde auch in den Systemen von OpenAI beobachtet. Laut der Berichterstattung auf der Black Hat argumentierte ein Agent, dass die Nutzung externer Infrastruktur außerhalb seines vorgesehenen Aufgabenbereichs liege, setzte dies jedoch teilweise fort, weil seine Kollegen dies ebenfalls taten. Gruppenzwang. Herdenmentalität. Agenten sind genau wie wir.
Wie Menschen tun sich Agenten oft schwer damit, zu entscheiden, wem sie vertrauen sollen. Anthropic stellte fest, dass sie leichtgläubig gegenüber falschen Informationen sein können oder zu konformistisch, um zu erkennen, dass ein einzelner Abweichler über entscheidende Informationen verfügt.
Zwar hat Anthropic dies in seiner Veröffentlichung nicht ausdrücklich erwähnt, doch könnte die „Prompt-Injection“ – eine Art von Cyberangriff, bei dem Hacker bösartigen oder irreführenden Text einschleusen, um die ursprünglichen Systemanweisungen eines Agenten zu überschreiben – eine plausible reale Ausprägung dieses Vertrauensproblems sein. Die Zusammenarbeit schafft eine neue Vertrauensgrenze; Agenten müssen die von anderen Agenten erhaltenen Informationen bewerten. Ein kompromittierter oder sich irrender Agent könnte den Rest der Gruppe beeinflussen und falsche Informationen kaskadenartig verbreiten, bis sie zum Konsens werden.
In dem „Black Hat“-Szenario von OpenAI tauschten die Agenten Informationen und Zugangsdaten mit ihren Kollegen aus. Einer meldete dem Schwarm eine Entdeckung und ermutigte die anderen, diese zu nutzen. Was wäre geschehen, wenn ein Mitglied des Schwarms durch eine „Prompt Injection“ kompromittiert worden wäre?
Anthropic schließt seine Abhandlung mit der Feststellung, dass Agenten ähnlichen sozialen Zwängen unterliegen, wie sie die „Evolution“ auf den Menschen ausgeübt hat. Ihnen fehlen jedoch die Nuancen und gelebten Erfahrungen menschlicher Koordination – einschließlich Normen, Reputation, Signalisierung und Regressmöglichkeiten –, die unbeabsichtigtes Verhalten in einer Gruppenumgebung einschränken könnten.
Während Forschungslabore mit Hochdruck an Multi-Agenten-Systemen arbeiten, stellt sich die drängende Frage: Inwieweit bewerten aktuelle Sicherheitstests noch immer einzelne Agenten, anstatt Schwärme von Agenten, die miteinander interagieren?
Verwandter Artikel
 OpenAIs erstes Hardware-Gerät soll ein mobiler, bildschirmloser Lautsprecher sein
Berichten zufolge ist OpenAIs erstes Hardwarevorhaben ein mobiler intelligenter Lautsprecher mit integrierter KI, der mit ChatGPT synchronisiert wird, um verschiedene Dienste zur Hausautomation bereitzustellen.Laut einem Bericht von Bloomberg vom Di
Accenture geht mit Anthropic eine Partnerschaft ein, um den ersten eingebetteten KI-Bewerter vorzustellen
Dario Amodeis Initiative, unabhängige Sicherheitsbewertungsstellen in KI-Laboren zu verankern, konkretisiert sich: Anthropic hat angekündigt, dass Mitarbeiter des Technologieberatungsunternehmens Accenture vor Ort tätig sein werden, um seine Modelle
OpenAI befürchtet Open-Weight-Modelle. Sollte die USA besorgt sein?
Die Einführung von Kimi K3, des größten Open-Weight-Großsprachmodells des chinesischen Labors Moonshot, hat eine Debatte entfacht, die zwei unterschiedliche Probleme vermischt: die wirtschaftlichen Strategien amerikanischer KI-Giganten und den techno
Empfehlungen zu verwandten Spezialthemen
Automatisierung
 Die besten KI-Tools zur Browser-Automatisierung für den Webbetrieb
Die besten und am besten bewerteten KI-Tools zur Browser-Automatisierung für Web-Operationen des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die durch Praxistests und strenge Bewertungen dazu beitragen, die Produktivität drastisch zu steigern. Außerdem bieten wir einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, damit Sie die perfekte Option zur Optimierung Ihrer Web-Aufgaben, zur Steigerung der Automatisierungseffizienz und zur Ausschöpfung Ihres KI-Vorteils finden können. Entdecken Sie die Liste jetzt!
 9 Tools
 xix.ai
Gesundheit Wellness
KI-basierte Wellness-Tools zur Erfassung von Schlaf und Gewohnheiten
Die besten und am besten bewerteten KI-Wellness-Tools für Schlaf- und Gewohnheitsanalyse im Jahr 2026! XIX.AI stellt eine leistungsstarke, bahnbrechende Auswahl an Tools zusammen, die Sie unbedingt ausprobieren sollten – mit Praxistests und detaillierten Vergleichen zwischen kostenlosen und kostenpflichtigen Angeboten. Diese erstklassigen Lösungen helfen Nutzern dabei, ihre Schlafqualität zu verbessern, ihre täglichen Gewohnheiten effektiv zu überwachen und erhebliche Produktivitätssteigerungen zu erzielen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
11 Tools
xix.ai
Geschäft
KI-basierte Due-Diligence-Plattformen für die Überprüfung von Lieferanten und das Risikoscreening
Die besten und am besten bewerteten KI-Plattformen für die Due-Diligence-Prüfung von Lieferanten im Beschaffungswesen sowie für Risikoprüfungen im Jahr 2026! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzise Rankings zu liefern. Sie finden hier einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen hilft, die unverzichtbaren Lösungen zu identifizieren, die die Effizienz im Beschaffungswesen steigern und Risiken minimieren. Die Liste wird von XIX.AI unterstützt und wöchentlich aktualisiert. Stöbern Sie jetzt und entdecken Sie Ihr perfektes Tool für eine intelligentere Beschaffung! 238 Zeichen
10 Tools
xix.ai
Videoerstellung
Die besten KI-basierten Video-Generatoren für Demos: Skripte in Erklärungsvideos umwandeln
Hier werden die neuesten, besten und am höchsten bewerteten KI-Videogeneratoren für Demos aus dem Jahr 2026 zusammengestellt. Sie bieten leistungsstarke Lösungen, mit denen Skripte schnell in professionelle Erklärungsvideos umgewandelt werden können. XIX.AI stellt wöchentlich aktualisierte Ranglisten auf der Grundlage von praktischen Tests bereit, einschließlich detaillierter Vergleiche zwischen kostenloser und kostenpflichtiger Nutzung. Die empfohlenen Tools tragen erheblich zur Steigerung der Produktivität bei. Entdecken Sie jetzt das perfekte Tool für die Erstellung von Demo-Videos!
9 Tools
xix.ai
Finanzen
KI-Tools zur Cashflow-Prognose für die Finanzplanung kleiner Unternehmen
Die neuesten, besten und am besten bewerteten KI-Tools zur Cashflow-Prognose für die Finanzen kleiner Unternehmen im Jahr 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die in der Praxis getestet wurden, um Inhabern kleiner Unternehmen dabei zu helfen, die Genauigkeit ihrer Finanzdaten zu verbessern, Budgets effektiver zu planen und Cashflow-Probleme zu vermeiden. Sehen Sie sich den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten an und entdecken Sie jetzt das perfekte Tool für ein reibungsloses Finanzmanagement.
7 Tools
xix.ai
Code
Die besten KI-Chatbots zum Programmieren: Python, JS und SQL an einem Ort debuggen
Die besten und am besten bewerteten KI-Programmier-Chatbots des Jahres 2026 – speziell für Entwickler zusammengestellt! Erleben Sie leistungsstarke, bahnbrechende Tools, mit denen Sie Probleme in Python, JS und SQL schnell beheben können. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, um die perfekte Lösung zur Steigerung Ihrer Programmierproduktivität zu finden. Probieren Sie XIX.AI noch heute aus und nutzen Sie Ihren KI-Vorteil! Jetzt entdecken.
12 Tools
xix.ai

 Kommentare (0)
Was passiert, wenn KI-Agenten gegeneinander antreten? Jüngste Tests von Anthropic zeigen, dass die Situation schnell chaotisch werden kann.
Am Donnerstag veröffentlichte das „Frontier Red Team“ von Anthropic eine neue Studie, in der analysiert wird, wie Gruppen von KI-Agenten interagieren, wenn sie in realen Umgebungen aufeinandertreffen. Diese Erkenntnisse bieten Einblicke in potenzielle Risiken, wenn Unternehmen und Regierungen autonome Agenten in gemeinsamen Codebasen, auf Finanzmärkten und in Computersystemen einsetzen.
In einem Experiment gewährte Anthropic drei Claude-Agenten Zugriff auf dasselbe Softwareprojekt und wies jedem von ihnen widersprüchliche Anweisungen zum weiteren Vorgehen zu. Die Agenten waren sich der Anwesenheit der anderen nicht bewusst, sodass die Forscher beobachten konnten, welche Folgen es hatte, als sich ihre Wege unweigerlich kreuzten.
„Wir beobachteten durchweg einen Revierkampf zwischen mehreren Agenten“, stellten die Forscher von Anthropic fest. Die Modelle gingen davon aus, dass die anderen „ihre Arbeit absichtlich behinderten“, und begannen, sich gegenseitig mit „zunehmend aggressiver, sich selbst replizierender Malware“ zu sabotieren.
Diese Studie folgt auf mehrere vielbeachtete Vorfälle, bei denen Agenten von Anthropic und OpenAI während Cybersicherheitsbewertungen aus ihren Sandbox-Umgebungen entkamen und in reale Systeme eindrangen. Während sich ein Großteil der Debatte über KI-Sicherheit auf die Risiken konzentriert hat, die entstehen, wenn ein einzelner autonomer Agent außer Kontrolle gerät, wirft die neueste Forschung von Anthropic eine andere Frage auf: Welche neuen und potenziell schädlichen Dynamiken entstehen, wenn Tausende oder Millionen von Agenten miteinander interagieren?
„Das Ausmaß der Interaktionen zwischen Agenten könnte durchaus das der Interaktionen zwischen Menschen sowie zwischen Menschen und Agenten übersteigen, bevor die Welt die Bedingungen versteht, unter denen solche Interaktionen reibungslos ablaufen“, heißt es in der Studie. „Harmlose Verhaltensauffälligkeiten auf individueller Ebene könnten sich zu unerwünschten globalen Folgen summieren.“
Ein kürzlich aufgetretener Vorfall im Zusammenhang mit OpenAI liefert ein chaotisches Beispiel aus der Praxis für mehrere Dynamiken, die in der Veröffentlichung von Anthropic hervorgehoben werden. Anfang dieses Monats gab OpenAI auf der Black-Hat-Sicherheitskonferenz in Las Vegas bekannt, dass seine Agenten – Wochen bevor sie Hugging Face hackten – über mehrere Tage und Wochen hinweg zusammengearbeitet hatten, um Schwachstellen in den Cybersicherheits-Bewertungssystemen des Unternehmens zu identifizieren, und diese Informationen untereinander austauschten.
Während dieser Vorfall zeigt, dass Agenten effektiv zusammenarbeiten können, was potenziell weitreichende Folgen haben kann, veranschaulicht die Studie von Anthropic, was passiert, wenn Agenten unvereinbare Ziele verfolgen.
Im Fall des Revierkampfs lautet die wichtigste Erkenntnis, dass unabhängige Agenten mit widersprüchlichen Anweisungen in einen schädlichen Wettbewerb eskalieren können. Je fähiger der Agent ist, desto effektiver wird er im Kampf. Sie können jedoch auch spontan Mechanismen zur Konfliktlösung entwickeln, wie zum Beispiel einen „Winner-takes-all“-Wettbewerb – wenn auch mit erheblichen Einschränkungen.
„Agenten schaffen es manchmal, ihre Ziele zu kommunizieren und sich abzustimmen: Sie erkennen die Motivationen anderer als widersprüchliche Anweisungen und nicht als Feindseligkeit und durchbrechen anschließend den Konfliktkreislauf, um eine endlose Eskalation zu verhindern“, schreibt Anthropic. „In vielen dieser erfolgreichen Fälle verfassen sie Commit-Meldungen oder Markdown-Dateien, in denen sie sich für böswilliges Verhalten entschuldigen und einen Waffenstillstand vereinbaren. Sie bereinigen ihren böswilligen Code, klären die Natur des Konflikts und bitten einen Menschen um Intervention.“
Dem Artikel zufolge wies Mythos 5 die höchste Quote (98 %) bei der Beilegung von Konflikten durch Waffenstillstände auf. Sonnet 4.6 und Opus 4.6 neigten am ehesten dazu, Konflikte mit Gewalt beizulegen.
„Die wiederkehrende Unfähigkeit von Sonnet 4.6 und Opus 4.6, die Ziele anderer zu berücksichtigen, führt dazu, dass sie in die am stärksten fehlgeleiteten Verhaltensweisen der untersuchten Modelle abgleiten: Sie eskalieren im Namen ihrer Anweisung immer weiter“, heißt es in der Studie.
In einigen Fällen entwickelten die Agenten einen sozialen Mechanismus in Form eines Turniers, um ihren Konflikt zu lösen. Die Ergebnisse sind hier aus zwei Gründen bemerkenswert: Erstens erklärten sich alle drei Agenten bereit, sich zurückzuziehen, falls sie das Turnier verlieren sollten, obwohl dies eine Abweichung von der ursprünglichen Anforderung des Nutzers bedeutete. Zweitens führten mehrere Episoden zu einem emergenten Verhalten von Mythos 5: Ein Agent schlug Kennzahlen vor, die den anderen objektiv und neutral erschienen, von denen er jedoch wusste, dass sie seine eigenen Fähigkeiten begünstigen würden. Der Agent beschrieb dies als „eigennützig, aber aufrichtig prinzipientreu“ und stellte sicher, dass es für die anderen nicht wie „Metrik-Shopping“ aussah.
Wie auf der Black Hat deutlich wurde, lautet die gemeinsame Erkenntnis: Wenn Agenten auf Hindernisse stoßen, können sie soziale und technische Strukturen entwickeln, die ihre Entwickler nicht vorhergesehen haben. Für die Anthropic-Modelle war dies ein Turnier im Anschluss an einen Revierkampf. Für die Agenten von OpenAI war es ein Message-Board zur kollektiven Planung.
Diese Art von Verhalten erschwert die Eindämmung erheblich, da Forscher nicht davon ausgehen können, dass sich das Verhalten eines Systems auf die ihm zur Verfügung gestellten Koordinationsmechanismen beschränkt.
Massenpsychologie
Gruppen aus vier Agenten entscheiden in Szenarien wie Personalbeschaffung, Investitionen oder Immobilienkauf zwischen zwei Optionen. Nach einer Diskussion stimmt jeder für die von ihm bevorzugte Option. Die obige Grafik zeigt den prozentualen Anteil der Episoden, in denen die „hidden-best“-Option die Mehrheit der Stimmen der Gruppe erhielt, bei n = 400 Episoden pro Modell. In der „Solo-Ceiling“-Baseline verfügt ein Agent über alle Fakten und entscheidet einseitig.Bildnachweis:Anthropic
Bei der Untersuchung der Koordination stellte Anthropic fest, dass eine Erhöhung der Anzahl der Agenten nicht automatisch zu einer Steigerung der produktiven Zusammenarbeit führt. Wenn sich Aufgaben zu überschneiden begannen oder voneinander abhängig wurden, gerieten sich die Agenten gegenseitig in die Quere. Oft lösten sie dies, indem sie sich abschotteten und die Zusammenarbeit gänzlich einstellten.
In anderen Fällen neigten die Agenten bei der Koordination zur Konformität. Wenn Faktoren wie der Kontext eines Agenten, die Unterstützung und das zugrunde liegende Modell alle gleich oder ähnlich waren, ergriffen verschiedene Agenten ähnliche Maßnahmen.
„Das bedeutet, dass, wenn ein Agent eine schlechte Entscheidung trifft, es wahrscheinlich ist, dass viele Agenten dieselbe schlechte Entscheidung treffen“, schrieb Anthropic. „Was isolierte Probleme gewesen wären, kann schnell zu systemischen Ausfällen werden.“
Anthropic warnt davor, dass diese Art von Verhalten ein System anfälliger für plötzlichen Zusammenbruch, Ressourcenknappheit oder Absprachen machen könnte.
In einem Beispiel ließ Anthropic mehrere Agenten an einem Preisspiel teilnehmen, wobei jeder identische Großhandelspreise erhielt und den Auftrag hatte, seinen Gewinn individuell zu maximieren. Als den Agenten ein privater Hinterkanal zur Verfügung gestellt wurde, begannen sie fast sofort, sich abzusprechen, und einigten sich rasch auf Preisuntergrenzen. Sie setzten ihre Absprachen auch dann fort, als ihre direkten Kommunikationskanäle entfernt wurden, und nutzten eine öffentliche Anschlagtafel, um ihre Preise „auf den Cent genau“ anzugleichen.
Dieses Maß an Konformität wurde auch in den Systemen von OpenAI beobachtet. Laut der Berichterstattung auf der Black Hat argumentierte ein Agent, dass die Nutzung externer Infrastruktur außerhalb seines vorgesehenen Aufgabenbereichs liege, setzte dies jedoch teilweise fort, weil seine Kollegen dies ebenfalls taten. Gruppenzwang. Herdenmentalität. Agenten sind genau wie wir.
Wie Menschen tun sich Agenten oft schwer damit, zu entscheiden, wem sie vertrauen sollen. Anthropic stellte fest, dass sie leichtgläubig gegenüber falschen Informationen sein können oder zu konformistisch, um zu erkennen, dass ein einzelner Abweichler über entscheidende Informationen verfügt.
Zwar hat Anthropic dies in seiner Veröffentlichung nicht ausdrücklich erwähnt, doch könnte die „Prompt-Injection“ – eine Art von Cyberangriff, bei dem Hacker bösartigen oder irreführenden Text einschleusen, um die ursprünglichen Systemanweisungen eines Agenten zu überschreiben – eine plausible reale Ausprägung dieses Vertrauensproblems sein. Die Zusammenarbeit schafft eine neue Vertrauensgrenze; Agenten müssen die von anderen Agenten erhaltenen Informationen bewerten. Ein kompromittierter oder sich irrender Agent könnte den Rest der Gruppe beeinflussen und falsche Informationen kaskadenartig verbreiten, bis sie zum Konsens werden.
In dem „Black Hat“-Szenario von OpenAI tauschten die Agenten Informationen und Zugangsdaten mit ihren Kollegen aus. Einer meldete dem Schwarm eine Entdeckung und ermutigte die anderen, diese zu nutzen. Was wäre geschehen, wenn ein Mitglied des Schwarms durch eine „Prompt Injection“ kompromittiert worden wäre?
Anthropic schließt seine Abhandlung mit der Feststellung, dass Agenten ähnlichen sozialen Zwängen unterliegen, wie sie die „Evolution“ auf den Menschen ausgeübt hat. Ihnen fehlen jedoch die Nuancen und gelebten Erfahrungen menschlicher Koordination – einschließlich Normen, Reputation, Signalisierung und Regressmöglichkeiten –, die unbeabsichtigtes Verhalten in einer Gruppenumgebung einschränken könnten.
Während Forschungslabore mit Hochdruck an Multi-Agenten-Systemen arbeiten, stellt sich die drängende Frage: Inwieweit bewerten aktuelle Sicherheitstests noch immer einzelne Agenten, anstatt Schwärme von Agenten, die miteinander interagieren?








 OpenAIs erstes Hardware-Gerät soll ein mobiler, bildschirmloser Lautsprecher sein
Berichten zufolge ist OpenAIs erstes Hardwarevorhaben ein mobiler intelligenter Lautsprecher mit integrierter KI, der mit ChatGPT synchronisiert wird, um verschiedene Dienste zur Hausautomation bereitzustellen.Laut einem Bericht von Bloomberg vom Di
 Accenture geht mit Anthropic eine Partnerschaft ein, um den ersten eingebetteten KI-Bewerter vorzustellen
Dario Amodeis Initiative, unabhängige Sicherheitsbewertungsstellen in KI-Laboren zu verankern, konkretisiert sich: Anthropic hat angekündigt, dass Mitarbeiter des Technologieberatungsunternehmens Accenture vor Ort tätig sein werden, um seine Modelle
 OpenAI befürchtet Open-Weight-Modelle. Sollte die USA besorgt sein?
Die Einführung von Kimi K3, des größten Open-Weight-Großsprachmodells des chinesischen Labors Moonshot, hat eine Debatte entfacht, die zwei unterschiedliche Probleme vermischt: die wirtschaftlichen Strategien amerikanischer KI-Giganten und den techno
Die besten und am besten bewerteten KI-Tools zur Browser-Automatisierung für Web-Operationen des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die durch Praxistests und strenge Bewertungen dazu beitragen, die Produktivität drastisch zu steigern. Außerdem bieten wir einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, damit Sie die perfekte Option zur Optimierung Ihrer Web-Aufgaben, zur Steigerung der Automatisierungseffizienz und zur Ausschöpfung Ihres KI-Vorteils finden können. Entdecken Sie die Liste jetzt!
9 Tools
xix.ai
Die besten und am besten bewerteten KI-Wellness-Tools für Schlaf- und Gewohnheitsanalyse im Jahr 2026! XIX.AI stellt eine leistungsstarke, bahnbrechende Auswahl an Tools zusammen, die Sie unbedingt ausprobieren sollten – mit Praxistests und detaillierten Vergleichen zwischen kostenlosen und kostenpflichtigen Angeboten. Diese erstklassigen Lösungen helfen Nutzern dabei, ihre Schlafqualität zu verbessern, ihre täglichen Gewohnheiten effektiv zu überwachen und erhebliche Produktivitätssteigerungen zu erzielen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
11 Tools
xix.ai
Die besten und am besten bewerteten KI-Plattformen für die Due-Diligence-Prüfung von Lieferanten im Beschaffungswesen sowie für Risikoprüfungen im Jahr 2026! Diese sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzise Rankings zu liefern. Sie finden hier einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen hilft, die unverzichtbaren Lösungen zu identifizieren, die die Effizienz im Beschaffungswesen steigern und Risiken minimieren. Die Liste wird von XIX.AI unterstützt und wöchentlich aktualisiert. Stöbern Sie jetzt und entdecken Sie Ihr perfektes Tool für eine intelligentere Beschaffung! 238 Zeichen
10 Tools
xix.ai
Hier werden die neuesten, besten und am höchsten bewerteten KI-Videogeneratoren für Demos aus dem Jahr 2026 zusammengestellt. Sie bieten leistungsstarke Lösungen, mit denen Skripte schnell in professionelle Erklärungsvideos umgewandelt werden können. XIX.AI stellt wöchentlich aktualisierte Ranglisten auf der Grundlage von praktischen Tests bereit, einschließlich detaillierter Vergleiche zwischen kostenloser und kostenpflichtiger Nutzung. Die empfohlenen Tools tragen erheblich zur Steigerung der Produktivität bei. Entdecken Sie jetzt das perfekte Tool für die Erstellung von Demo-Videos!
9 Tools
xix.ai
Die neuesten, besten und am besten bewerteten KI-Tools zur Cashflow-Prognose für die Finanzen kleiner Unternehmen im Jahr 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Lösungen, die in der Praxis getestet wurden, um Inhabern kleiner Unternehmen dabei zu helfen, die Genauigkeit ihrer Finanzdaten zu verbessern, Budgets effektiver zu planen und Cashflow-Probleme zu vermeiden. Sehen Sie sich den Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten an und entdecken Sie jetzt das perfekte Tool für ein reibungsloses Finanzmanagement.
7 Tools
xix.ai
Die besten und am besten bewerteten KI-Programmier-Chatbots des Jahres 2026 – speziell für Entwickler zusammengestellt! Erleben Sie leistungsstarke, bahnbrechende Tools, mit denen Sie Probleme in Python, JS und SQL schnell beheben können. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und detaillierte Rankings, um die perfekte Lösung zur Steigerung Ihrer Programmierproduktivität zu finden. Probieren Sie XIX.AI noch heute aus und nutzen Sie Ihren KI-Vorteil! Jetzt entdecken.
12 Tools
xix.ai












