вариант
Дом
Срочные новости
Содержание
HenryDavis
HenryDavis
12 июня 2026 г.

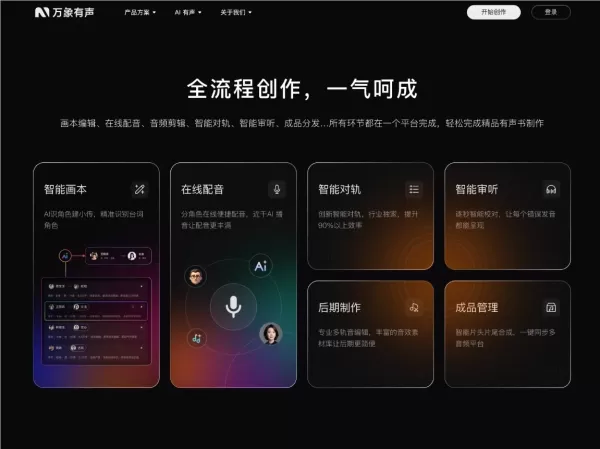
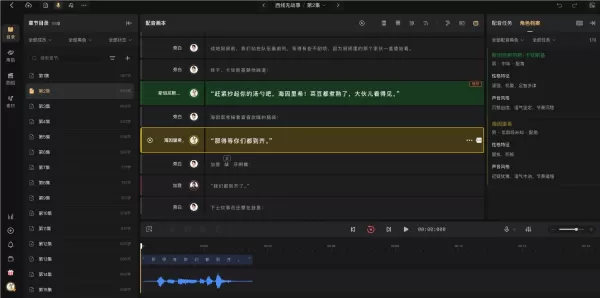
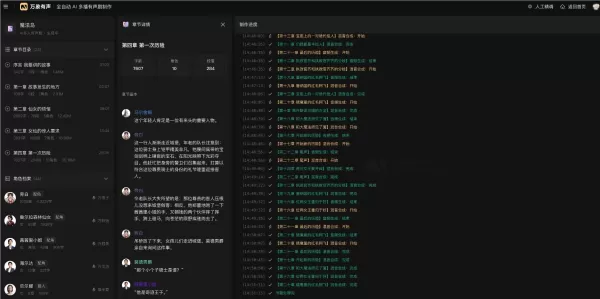
Компания Wanzhuang Yousheng выпустила полностью автоматическую систему создания аудиокниг с использованием искусственного интеллекта и множества голосов, предназначенную для клиентов вторичного уровня, таких как издательские платформы. Стоимость услуги составляет всего 7 юаней за 10 000 символов, что позволяет массово преобразовывать контент в формат аудиокниг. Двухканальная система объединяет высококачественное сотрудничество человека и ИИ с полностью автоматизированным процессом массового производства.
Компания Wanzhuang Yousheng выпустила полностью автоматическую систему создания аудиокниг с использованием искусственного интеллекта и множества голосов, предназначенную для клиентов вторичного уровня, таких как издательские платформы. Стоимость услуги составляет всего 7 юаней за 10 000 символов, что позволяет массово преобразовывать контент в формат аудиокниг. Двухканальная система объединяет высококачественное сотрудничество человека и ИИ с полностью автоматизированным процессом массового производства. Компания Wanzhuang Yousheng выпустила полностью автоматическую систему создания аудиокниг с использованием искусственного интеллекта и множества голосов, предназначенную для клиентов вторичного уровня, таких как издательские платформы. Стоимость услуги составляет всего 7 юаней за 10 000 символов, что позволяет массово преобразовывать контент в формат аудиокниг. Двухканальная система объединяет высококачественное сотрудничество человека и ИИ с полностью автоматизированным процессом массового производства. Компания Wanzhuang Yousheng выпустила полностью автоматическую систему создания аудиокниг с использованием искусственного интеллекта и множества голосов, предназначенную для клиентов вторичного уровня, таких как издательские платформы. Стоимость услуги составляет всего 7 юаней за 10 000 символов, что позволяет массово преобразовывать контент в формат аудиокниг. Двухканальная система объединяет высококачественное сотрудничество человека и ИИ с полностью автоматизированным процессом массового производства.
Автор CarlGarcia CarlGarcia 9 октября 2026 г.
Исследователи из Мельбурнского университета и Университета Нового Южного Уэльса представили VoxMem — новый бенчмарк, выявляющий критические недостатки текущих методов оценки памяти голосового искусственного интеллекта. В отличие от предыдущих подходов, игнорирующих нюансы аудио, VoxMem изолирует длину разговора для проверки способности моделей запоминать личность говорящего, тон голоса и фоновые звуки на основе 34 743 аудиозаписей. Тестирование 15 популярных моделей показало, что ни одна из них не достигает точности выше 40% при длине контекста в 32K токенов. Модели демонстрируют значительные трудности с распознаванием паралингвистических сигналов и звуков окружающей среды, причем их эффективность снижается по мере увеличения объема истории диалога, что подчеркивает существенный пробел в возможностях понимания длинных аудиозаписей.
OR