옵션
속보
콘텐츠
WalterMartinez
WalterMartinez
2026년 9월 18일

Zhipu는 초당 200 토큰을 처리하는 고속 AI 모델인 GLM-5.3-FlashX를 출시했습니다. 널리 사용되는 GLM-5.3-Flash를 기반으로 구축된 이 모델은 10만 개의 국산 칩을 활용해 추론 성능을 최적화했습니다. 이번 업데이트는 지능, 비용, 속도의 균형을 맞추어, 이전 버전의 뛰어난 성능을 유지하면서도 기업 개발자의 작업 속도를 획기적으로 향상시킵니다.
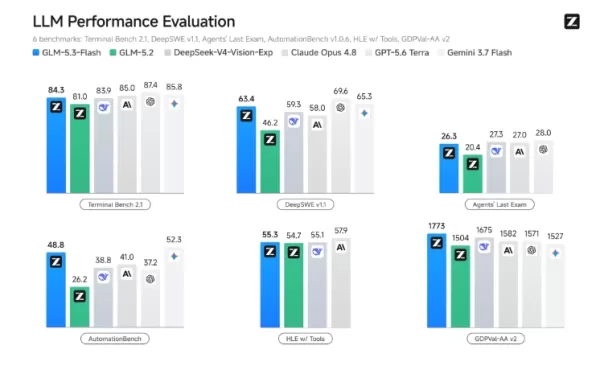
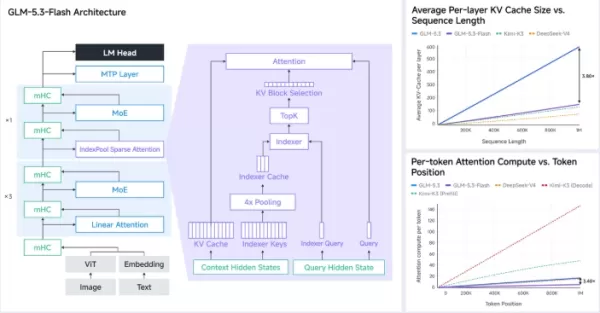
Zhipu는 초당 200 토큰을 처리하는 고속 AI 모델인 GLM-5.3-FlashX를 출시했습니다. 널리 사용되는 GLM-5.3-Flash를 기반으로 구축된 이 모델은 10만 개의 국산 칩을 활용해 추론 성능을 최적화했습니다. 이번 업데이트는 지능, 비용, 속도의 균형을 맞추어, 이전 버전의 뛰어난 성능을 유지하면서도 기업 개발자의 작업 속도를 획기적으로 향상시킵니다. Zhipu는 초당 200 토큰을 처리하는 고속 AI 모델인 GLM-5.3-FlashX를 출시했습니다. 널리 사용되는 GLM-5.3-Flash를 기반으로 구축된 이 모델은 10만 개의 국산 칩을 활용해 추론 성능을 최적화했습니다. 이번 업데이트는 지능, 비용, 속도의 균형을 맞추어, 이전 버전의 뛰어난 성능을 유지하면서도 기업 개발자의 작업 속도를 획기적으로 향상시킵니다.
의견 (0)
0/300
OR