


 집
통계 분석에서 연관성과 인과성의 차이는 무엇인가?
변수 간의 관계를 이해하는 것은 데이터 분석에서 매우 중요합니다. 통계는 결과를 예측하는 데 도움을 주지만, 단순한 연관성과 진정한 인과관계를 구분하는 것이 필수적입니다. 두 변수 간의 관계가 한 변수가 다른 변수를 유발한다는 의미는 아닙니다. 이 가이드는 이러한 핵심 개념을 탐구하고 모집단, 표본, 모수를 정의하는 방법을 가르쳐, 보다 신뢰할 수 있고 데이터에 기반한 의사결정을 내릴 수 있도록 지원합니다.
핵심 포인트
통계적 연관성과 인과관계를 구분하는 법을 익히세요.
연구 대상 모집단, 추출된 표본, 주요 매개변수를 정의하세요.
다양한 표본 추출 방법을 탐구하고, 그것이 모집단을 얼마나 잘 대표하는지 평가하세요.
편의 표본 추출과 체계적 표본 추출의 용도와 한계를 파악하세요.
이러한 통계적 원리를 적용하여 데이터 해석 및 의사결정 능력을 향상시키십시오.
상관관계 vs 인과관계: 통계적 진실의 베일을 벗기다
핵심 차이: 연관성과 인과관계
데이터 분석에서 목표는 종종 관찰된 패턴을 바탕으로 미래 사건을 예측하는 것이다. 때로는 단순히 한 변수가 다른 변수와 연관되어 있는지 판단하는 것이 목적일 수도 있다.
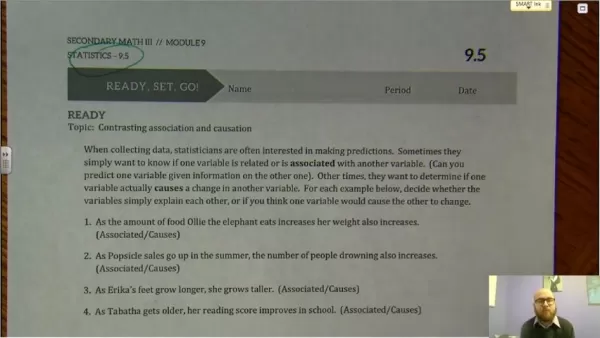
연관성은 예측 가능한 연결을 의미합니다. 한 변수의 값을 알면 다른 변수를 추정하는 데 도움이 됩니다. 예를 들어, 아이스크림 판매량과 범죄율은 여름철에 증가하는 경향이 있습니다. 이들은 상관관계가 있습니다.
그러나 이를 인과관계로 오해하는 것은 치명적인 오류입니다. 인과관계란 한 변수의 변화가 다른 변수의 변화를 직접적으로 유발한다는 의미입니다. 인과관계를 입증하는 것은 훨씬 더 까다로우며, 다른 영향 요인을 배제하기 위한 엄격한 검증이 필요합니다. 아이스크림 판매 증가가 범죄 증가를 유발하는 것이 아닙니다. 더운 날씨 같은 제3의 변수가 두 추세 모두에 영향을 미칩니다.
이 차이를 이해하는 것은 합리적인 의사결정에 필수적입니다. 상관관계를 인과관계로 오인하면 비효율적인 정책과 잘못된 결론으로 이어질 수 있습니다. 견고한 통계 분석은 단순한 우연과 진정한 인과관계를 구분하여 이러한 관계를 명확히 하는 것을 목표로 합니다.
개념을 설명하는 예시
연관성과 인과관계의 차이를 명확히 하기 위해 다음과 같은 실제 사례를 고려해 보십시오.
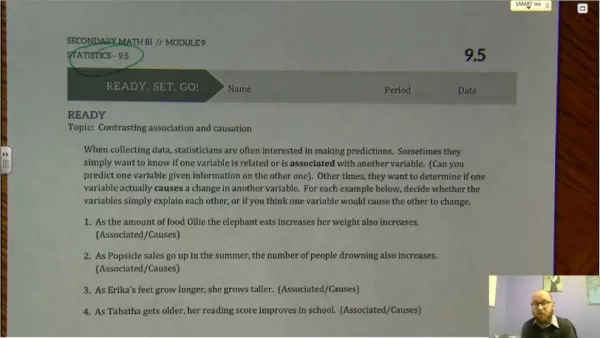
- 코끼리 올리: 코끼리 올리가 더 많은 음식을 먹을수록 체중이 증가합니다. 이는 연관성인가 인과관계인가? 여기서 음식의 양이 올리의 체중 변화에 직접적인 원인이 됩니다. 이는 명백한 인과관계입니다.
- 아이스크림 판매량과 익사 사고: 여름이면 아이스크림 판매량이 증가하고 익사 사고도 늘어난다. 이는 연관성인가 인과관계인가? 두 변수는 관련이 있으나, 아이스크림 판매 증가가 익사 사고를 유발하지는 않는다. 여름 더위와 수영 활동 증가라는 제3의 요인이 양쪽에 영향을 미친다. 이는 연관성이다.
- 에리카의 발과 키: 에리카의 발이 길어질수록 키도 커진다. 이는 연관성인가 인과관계인가? 발의 성장과 키는 에리카의 전반적인 신체 발달과 연결되어 상관관계를 보인다. 발과 장골의 성장판이 동시에 성장에 기여한다는 점에서 인과관계를 주장할 수도 있다.
- 타바사의 독서 능력과 나이: 타바사가 나이를 먹을수록 학교 독서 점수가 향상됩니다. 이는 연관성인가 인과관계인가? 나이가 들면서 타바사는 더 많은 교육을 받고 경험을 쌓아 독서 능력이 직접적으로 발달합니다. 이 향상은 교육의 결과로 합리적으로 설명할 수 있습니다.
자주 묻는 질문
통계 분석에서 가장 흔한 실수는 무엇인가요?
가장 흔한 오류는 상관관계와 인과관계를 혼동하는 것입니다. 두 변수가 함께 변화한다고 해서 한 변수가 다른 변수를 유발한다는 증거가 되지 않습니다. 다른 숨겨진 요인이 작용할 수 있습니다.
표본의 대표성을 어떻게 높일 수 있나요?
단순 무작위 추출, 체계적 추출, 계층적 추출과 같은 무작위 표본 추출 기법을 사용하십시오. 또한 연구 대상 모집단의 다양성을 포착할 수 있을 만큼 표본 크기가 충분히 큰지 확인하십시오.
연구 대상 집단을 정확히 정의하는 것이 왜 중요한가요?
대상 모집단을 정확히 정의하면 표본 추출이 집중되고 관련성 있는 데이터를 수집할 수 있습니다. 예를 들어, 일반 대중의 통찰력을 원하지만 대학생만 조사한다면 결과는 왜곡되고 대표성이 떨어질 것입니다.
관련 질문
통계적 데이터 표본 추출 및 분석 시 고려해야 할 윤리적 사항은 무엇인가요?
윤리는 책임 있는 통계 작업의 기초가 되어 데이터 수집 및 해석 과정에서 피해, 편향, 허위 진술을 방지합니다. 참가자 개인정보 보호가 최우선입니다. 이는 사전 동의를 얻고, 데이터 사용 목적을 명확히 설명하며, 참여 철회 권리를 보장하는 것을 포함합니다. 특히 민감한 정보의 경우 데이터 익명화와 강력한 보안 프로토콜 구현이 필수적입니다. 편향 방지 역시 중요한 의무입니다. 연구자는 데이터 수집부터 해석까지 모든 단계에서 편향을 사전에 식별하고 완화해야 하며, 연구의 한계와 혼란 변수를 공개적으로 인정해야 합니다. 보고의 투명성과 정직성은 절대 양보할 수 없습니다. 초기 가설과 상충하더라도 결과를 정확하고 완전하게 제시해야 하며, 오해를 유발할 수 있는 선택적 보고나 조작을 피해야 합니다. 데이터는 차별이나 피해를 조장하는 데 사용되어서는 안 되며, 사회적 이익을 위해 책임감 있게 활용되어야 합니다. 이를 위해서는 연구가 다양한 집단에 미치는 영향을 고려하고 공정한 정책을 옹호해야 합니다. 연구자들은 전문적 기준을 준수하고 동료 검토를 수용하며 자신의 작업에 대해 책임을 져야 합니다. 마지막으로, 객관성과 공공의 신뢰를 유지하기 위해 이해 상충을 공개하고 관리하는 것이 중요합니다. 이러한 윤리적 기준을 준수함으로써 통계 분석은 개인의 권리와 공동체 복지를 존중하는 진보를 위한 신뢰할 수 있는 도구가 됩니다.
관련 기사
 OpenAI, 성장 둔화 우려 불식…여러 사업부門 가속화
외부로부터의 판매 성장 둔화 및 내부 목표 미달성에 대한 scrutiny에 대응하여, AI 선도 기업 오픈AI는 4월 28일 화요일에 자신감 있는 성명을 발표했다. 이 회사는 소비자 제품과 기업 서비스의 빠른 진전을 명확히 하며, 최근 제기된 사업 둔화에 대한 추측을 직접적으로 반박했다.동사가 "여러 내부 목표를 놓쳤다"는 주장에 대해, 오픈AI는 이러한 보도를 "전형적인 클릭베이트"로 일축했다. 이 회사는 AI 통합에 대한 강력한 기업 수요
알리바바 슈퍼컵: Qwen3.8-Max, 강화된 코딩 및 오피스 도구로 데뷔
Alibaba는 2.4조 개의 파라미터를 갖춘 차세대 기반 대형 모델인 Qwen3.8-Max를 공식적으로 공개했습니다. 이 중요한 AI 기술 발전은 코딩 및 전문 사무 작업 등 핵심 영역에서 상당한 성능 향상을 제공하며, 강력한 기술 역량을 보여줍니다.권위 있는 Arena 대형 모델 랭킹에서 Qwen3.8-Max는 Anthropic의 Claude 시리즈에 이어 우수한 성적을 거두며 업계 선두 그룹에 자리했습니다. 이 성과는 국내 대형 모델이
인도 기술 거대기업이 마이크로소프트 오피스의 AI 경쟁사에 3000만 달러 투자
시리즈 창업가 바힌 투라크히아는 3,000만 달러의 자금을 자신의 자본으로 투자하며, 엔터프라이즈 AI 분야에 여전히 신규 진입자에게 기회가 남아 있다고 믿고 있다. 그의 최신 스타트업 ‘Neo’는 핵심 신념을 바탕으로 운영된다: 기존 직장용 소프트웨어는 채팅봇으로 단순히 패치할 수 없으며, 아키텍처의 완전한 재설계가 필요하다는 것이다.46세의 투라크히아는 야심 찬 엔터프라이즈 테크 벤처를 지원해 온 이력이 있다. 지난 20년간 그는 Dire
관련 특별 주제 추천
챗봇
 면접 연습을 위한 최고의 AI 대화 트레이너 도구
2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
 12 도구
 xix.ai
디자인과 예술
창의적인 실험을 위한 최고의 AI 스타일 변환 도구
2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai
만화 창작
시각적 스토리텔링을 위한 최고의 AI 대화 풍선 도구
2026년 시각적 스토리텔링을 위한 최신 최고 평점의 AI 대화 풍선 도구가 XIX.AI에 소개됩니다! 이 엄선된 모음집에는 크리에이터들이 생산성을 높이고 창의적인 난관을 극복하는 데 도움을 주는, 강력하고 획기적인 도구들이 포함되어 있습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 실제 테스트 결과를 살펴보며, 최신 순위를 통해 매력적인 시각적 이야기를 만드는 데 꼭 필요한 솔루션을 찾아보세요. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 발견해 보세요!
10 도구
xix.ai
회의 도우미
최고의 AI 회의 요약 도구: 의사 결정 사항과 후속 조치를 명확하게 추적하세요
2026년 최신 최고 평점을 받은 최고의 AI 회의 요약 도구로, 명확한 의사 결정 추적과 손쉬운 후속 조치를 실현하세요. 이 엄선된 목록은 회의록 자동화, 핵심 실행 과제 파악, 모든 프로젝트에 걸친 팀 협업 효율화를 통해 생산성을 획기적으로 높여주는 강력하고 혁신적인 솔루션을 소개합니다. 무료 버전과 유료 버전의 비교 정보, 실제 사용 후기, 매주 업데이트되는 순위 정보를 통해 여러분에게 딱 맞는 도구를 찾아보세요. 지금 바로 살펴보고 AI의 힘을 경험해 보세요!
9 도구
xix.ai
데이터 분석
최고의 AI 데이터 정제 도구: 누락된 값과 중복 데이터를 신속하게 수정하기
2026년 최신의 우수하고 높은 평가를 받는 AI 데이터 정제 도구들로, 누락된 값과 중복 데이터를 신속하게 수정할 수 있습니다. 이 선별된 목록에는 생산성을 획기적으로 향상시켜 주는 강력한 솔루션이 포함되어 있습니다. 각 도구는 신뢰성을 보장하기 위해 엄격한 실제 환경 테스트를 거쳤습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 귀하의 요구사항에 가장 적합한 도구를 발견해 보세요. 지금 바로 XIX.AI에서 자세히 알아보시고 AI 분야에서의 경쟁 우위를 확보하세요.
11 도구
xix.ai
디자인과 예술
아티스트를 위한 최고의 AI 창의적 아이디어 도구: 시각적 블록을 돌파하라
2026년 최신 최고 인기 AI 창의적 아이디어 도구들은 XIX.AI가 선별한 것으로, 창작자들이 시각적 장벽을 돌파하고 즉각적으로 창의성을 높일 수 있도록 지원합니다. 이러한 강력한 혁신적 도구들은 실제 테스트 결과, 무료와 유료 버전의 상세 비교, 그리고 매주 업데이트되는 순위표를 제공합니다. 콘텐츠 제작을 가속화하고 AI 경쟁력을 발휘할 수 있는 완벽한 도구를 발견하세요. 지금 바로 탐색하세요!
14 도구
xix.ai

 의견 (1)
0/500
![MarkMartínez]()
這篇文章講得真清楚!以前總是把相關性和因果關係搞混,現在終於明白為什麼統計顯著不等於實際影響了。不過在實際應用中,要證明因果關係真的好難啊,尤其是社會科學研究🧐
변수 간의 관계를 이해하는 것은 데이터 분석에서 매우 중요합니다. 통계는 결과를 예측하는 데 도움을 주지만, 단순한 연관성과 진정한 인과관계를 구분하는 것이 필수적입니다. 두 변수 간의 관계가 한 변수가 다른 변수를 유발한다는 의미는 아닙니다. 이 가이드는 이러한 핵심 개념을 탐구하고 모집단, 표본, 모수를 정의하는 방법을 가르쳐, 보다 신뢰할 수 있고 데이터에 기반한 의사결정을 내릴 수 있도록 지원합니다.
핵심 포인트
통계적 연관성과 인과관계를 구분하는 법을 익히세요.
연구 대상 모집단, 추출된 표본, 주요 매개변수를 정의하세요.
다양한 표본 추출 방법을 탐구하고, 그것이 모집단을 얼마나 잘 대표하는지 평가하세요.
편의 표본 추출과 체계적 표본 추출의 용도와 한계를 파악하세요.
이러한 통계적 원리를 적용하여 데이터 해석 및 의사결정 능력을 향상시키십시오.
상관관계 vs 인과관계: 통계적 진실의 베일을 벗기다
핵심 차이: 연관성과 인과관계
데이터 분석에서 목표는 종종 관찰된 패턴을 바탕으로 미래 사건을 예측하는 것이다. 때로는 단순히 한 변수가 다른 변수와 연관되어 있는지 판단하는 것이 목적일 수도 있다.
연관성은 예측 가능한 연결을 의미합니다. 한 변수의 값을 알면 다른 변수를 추정하는 데 도움이 됩니다. 예를 들어, 아이스크림 판매량과 범죄율은 여름철에 증가하는 경향이 있습니다. 이들은 상관관계가 있습니다.
그러나 이를 인과관계로 오해하는 것은 치명적인 오류입니다. 인과관계란 한 변수의 변화가 다른 변수의 변화를 직접적으로 유발한다는 의미입니다. 인과관계를 입증하는 것은 훨씬 더 까다로우며, 다른 영향 요인을 배제하기 위한 엄격한 검증이 필요합니다. 아이스크림 판매 증가가 범죄 증가를 유발하는 것이 아닙니다. 더운 날씨 같은 제3의 변수가 두 추세 모두에 영향을 미칩니다.
이 차이를 이해하는 것은 합리적인 의사결정에 필수적입니다. 상관관계를 인과관계로 오인하면 비효율적인 정책과 잘못된 결론으로 이어질 수 있습니다. 견고한 통계 분석은 단순한 우연과 진정한 인과관계를 구분하여 이러한 관계를 명확히 하는 것을 목표로 합니다.
개념을 설명하는 예시
연관성과 인과관계의 차이를 명확히 하기 위해 다음과 같은 실제 사례를 고려해 보십시오.
- 코끼리 올리: 코끼리 올리가 더 많은 음식을 먹을수록 체중이 증가합니다. 이는 연관성인가 인과관계인가? 여기서 음식의 양이 올리의 체중 변화에 직접적인 원인이 됩니다. 이는 명백한 인과관계입니다.
- 아이스크림 판매량과 익사 사고: 여름이면 아이스크림 판매량이 증가하고 익사 사고도 늘어난다. 이는 연관성인가 인과관계인가? 두 변수는 관련이 있으나, 아이스크림 판매 증가가 익사 사고를 유발하지는 않는다. 여름 더위와 수영 활동 증가라는 제3의 요인이 양쪽에 영향을 미친다. 이는 연관성이다.
- 에리카의 발과 키: 에리카의 발이 길어질수록 키도 커진다. 이는 연관성인가 인과관계인가? 발의 성장과 키는 에리카의 전반적인 신체 발달과 연결되어 상관관계를 보인다. 발과 장골의 성장판이 동시에 성장에 기여한다는 점에서 인과관계를 주장할 수도 있다.
- 타바사의 독서 능력과 나이: 타바사가 나이를 먹을수록 학교 독서 점수가 향상됩니다. 이는 연관성인가 인과관계인가? 나이가 들면서 타바사는 더 많은 교육을 받고 경험을 쌓아 독서 능력이 직접적으로 발달합니다. 이 향상은 교육의 결과로 합리적으로 설명할 수 있습니다.
자주 묻는 질문
통계 분석에서 가장 흔한 실수는 무엇인가요?
가장 흔한 오류는 상관관계와 인과관계를 혼동하는 것입니다. 두 변수가 함께 변화한다고 해서 한 변수가 다른 변수를 유발한다는 증거가 되지 않습니다. 다른 숨겨진 요인이 작용할 수 있습니다.
표본의 대표성을 어떻게 높일 수 있나요?
단순 무작위 추출, 체계적 추출, 계층적 추출과 같은 무작위 표본 추출 기법을 사용하십시오. 또한 연구 대상 모집단의 다양성을 포착할 수 있을 만큼 표본 크기가 충분히 큰지 확인하십시오.
연구 대상 집단을 정확히 정의하는 것이 왜 중요한가요?
대상 모집단을 정확히 정의하면 표본 추출이 집중되고 관련성 있는 데이터를 수집할 수 있습니다. 예를 들어, 일반 대중의 통찰력을 원하지만 대학생만 조사한다면 결과는 왜곡되고 대표성이 떨어질 것입니다.
관련 질문
통계적 데이터 표본 추출 및 분석 시 고려해야 할 윤리적 사항은 무엇인가요?
윤리는 책임 있는 통계 작업의 기초가 되어 데이터 수집 및 해석 과정에서 피해, 편향, 허위 진술을 방지합니다. 참가자 개인정보 보호가 최우선입니다. 이는 사전 동의를 얻고, 데이터 사용 목적을 명확히 설명하며, 참여 철회 권리를 보장하는 것을 포함합니다. 특히 민감한 정보의 경우 데이터 익명화와 강력한 보안 프로토콜 구현이 필수적입니다. 편향 방지 역시 중요한 의무입니다. 연구자는 데이터 수집부터 해석까지 모든 단계에서 편향을 사전에 식별하고 완화해야 하며, 연구의 한계와 혼란 변수를 공개적으로 인정해야 합니다. 보고의 투명성과 정직성은 절대 양보할 수 없습니다. 초기 가설과 상충하더라도 결과를 정확하고 완전하게 제시해야 하며, 오해를 유발할 수 있는 선택적 보고나 조작을 피해야 합니다. 데이터는 차별이나 피해를 조장하는 데 사용되어서는 안 되며, 사회적 이익을 위해 책임감 있게 활용되어야 합니다. 이를 위해서는 연구가 다양한 집단에 미치는 영향을 고려하고 공정한 정책을 옹호해야 합니다. 연구자들은 전문적 기준을 준수하고 동료 검토를 수용하며 자신의 작업에 대해 책임을 져야 합니다. 마지막으로, 객관성과 공공의 신뢰를 유지하기 위해 이해 상충을 공개하고 관리하는 것이 중요합니다. 이러한 윤리적 기준을 준수함으로써 통계 분석은 개인의 권리와 공동체 복지를 존중하는 진보를 위한 신뢰할 수 있는 도구가 됩니다.








 OpenAI, 성장 둔화 우려 불식…여러 사업부門 가속화
외부로부터의 판매 성장 둔화 및 내부 목표 미달성에 대한 scrutiny에 대응하여, AI 선도 기업 오픈AI는 4월 28일 화요일에 자신감 있는 성명을 발표했다. 이 회사는 소비자 제품과 기업 서비스의 빠른 진전을 명확히 하며, 최근 제기된 사업 둔화에 대한 추측을 직접적으로 반박했다.동사가 "여러 내부 목표를 놓쳤다"는 주장에 대해, 오픈AI는 이러한 보도를 "전형적인 클릭베이트"로 일축했다. 이 회사는 AI 통합에 대한 강력한 기업 수요
 알리바바 슈퍼컵: Qwen3.8-Max, 강화된 코딩 및 오피스 도구로 데뷔
Alibaba는 2.4조 개의 파라미터를 갖춘 차세대 기반 대형 모델인 Qwen3.8-Max를 공식적으로 공개했습니다. 이 중요한 AI 기술 발전은 코딩 및 전문 사무 작업 등 핵심 영역에서 상당한 성능 향상을 제공하며, 강력한 기술 역량을 보여줍니다.권위 있는 Arena 대형 모델 랭킹에서 Qwen3.8-Max는 Anthropic의 Claude 시리즈에 이어 우수한 성적을 거두며 업계 선두 그룹에 자리했습니다. 이 성과는 국내 대형 모델이
 인도 기술 거대기업이 마이크로소프트 오피스의 AI 경쟁사에 3000만 달러 투자
시리즈 창업가 바힌 투라크히아는 3,000만 달러의 자금을 자신의 자본으로 투자하며, 엔터프라이즈 AI 분야에 여전히 신규 진입자에게 기회가 남아 있다고 믿고 있다. 그의 최신 스타트업 ‘Neo’는 핵심 신념을 바탕으로 운영된다: 기존 직장용 소프트웨어는 채팅봇으로 단순히 패치할 수 없으며, 아키텍처의 완전한 재설계가 필요하다는 것이다.46세의 투라크히아는 야심 찬 엔터프라이즈 테크 벤처를 지원해 온 이력이 있다. 지난 20년간 그는 Dire

2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai

2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai

2026년 시각적 스토리텔링을 위한 최신 최고 평점의 AI 대화 풍선 도구가 XIX.AI에 소개됩니다! 이 엄선된 모음집에는 크리에이터들이 생산성을 높이고 창의적인 난관을 극복하는 데 도움을 주는, 강력하고 획기적인 도구들이 포함되어 있습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 실제 테스트 결과를 살펴보며, 최신 순위를 통해 매력적인 시각적 이야기를 만드는 데 꼭 필요한 솔루션을 찾아보세요. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 발견해 보세요!
10 도구
xix.ai

2026년 최신 최고 평점을 받은 최고의 AI 회의 요약 도구로, 명확한 의사 결정 추적과 손쉬운 후속 조치를 실현하세요. 이 엄선된 목록은 회의록 자동화, 핵심 실행 과제 파악, 모든 프로젝트에 걸친 팀 협업 효율화를 통해 생산성을 획기적으로 높여주는 강력하고 혁신적인 솔루션을 소개합니다. 무료 버전과 유료 버전의 비교 정보, 실제 사용 후기, 매주 업데이트되는 순위 정보를 통해 여러분에게 딱 맞는 도구를 찾아보세요. 지금 바로 살펴보고 AI의 힘을 경험해 보세요!
9 도구
xix.ai

2026년 최신의 우수하고 높은 평가를 받는 AI 데이터 정제 도구들로, 누락된 값과 중복 데이터를 신속하게 수정할 수 있습니다. 이 선별된 목록에는 생산성을 획기적으로 향상시켜 주는 강력한 솔루션이 포함되어 있습니다. 각 도구는 신뢰성을 보장하기 위해 엄격한 실제 환경 테스트를 거쳤습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 귀하의 요구사항에 가장 적합한 도구를 발견해 보세요. 지금 바로 XIX.AI에서 자세히 알아보시고 AI 분야에서의 경쟁 우위를 확보하세요.
11 도구
xix.ai

2026년 최신 최고 인기 AI 창의적 아이디어 도구들은 XIX.AI가 선별한 것으로, 창작자들이 시각적 장벽을 돌파하고 즉각적으로 창의성을 높일 수 있도록 지원합니다. 이러한 강력한 혁신적 도구들은 실제 테스트 결과, 무료와 유료 버전의 상세 비교, 그리고 매주 업데이트되는 순위표를 제공합니다. 콘텐츠 제작을 가속화하고 AI 경쟁력을 발휘할 수 있는 완벽한 도구를 발견하세요. 지금 바로 탐색하세요!
14 도구
xix.ai

這篇文章講得真清楚!以前總是把相關性和因果關係搞混,現在終於明白為什麼統計顯著不等於實際影響了。不過在實際應用中,要證明因果關係真的好難啊,尤其是社會科學研究🧐












