


 집
아마존 코딩 면접에서 오른쪽 더 큰 요소 문제를 해결하는 방법은 무엇입니까?
Amazon에서 코딩 면접을 준비하는 것은 상당한 도전이 될 수 있습니다. 자주 출제되는 질문 중 하나는 배열과 논리적 추론에 초점을 맞춘 것입니다. 이 글에서는 배열의 각 항목에 대해 오른쪽에서 다음으로 큰 요소를 식별하는 일반적인 아마존 코딩 면접 문제를 해결하는 방법에 대해 자세히 설명합니다. 문제 정의를 살펴보고, 예시를 통해 작업하고, 기본 논리를 설명하고, 코드 구현을 살펴봅니다. 이 가이드가 끝나면 Amazon 기술 면접에서 성공하는 데 도움이 되는 귀중한 기술을 습득하게 될 것입니다. 이 문제를 마스터하는 것은 Amazon에 입사하기 위한 효과적인 준비 전략의 핵심 요소입니다.
핵심 포인트
핵심 목표를 파악하세요: 배열의 각 요소에 대해 오른쪽에서 가장 큰 요소를 찾습니다.
마지막 요소에는 오른쪽에 요소가 없으므로 -1의 값을 할당합니다.
최적의 해는 배열의 끝에서 시작까지 배열을 가로지르는 것입니다.
단일 변수를 유지하여 지금까지 표시된 최대값을 추적하여 공간 요구 사항을 최소화합니다.
각 단계에서 현재 요소와 저장된 최대값을 비교하고 적절하게 값을 업데이트합니다.
코드 구현은 런타임 효율성과 메모리 사용량 최소화를 우선시합니다.
제로 스페이스 접근 방식은 추가 데이터 구조 없이 배열을 직접 업데이트하는 방식입니다.
기본 기법은 주어진 배열 자체 내에서 반복과 업데이트를 수행하는 것입니다.
문제 이해: 오른쪽에 있는 더 큰 요소
문제 설명
이 문제의 목적은 주어진 배열을 처리하고 모든 요소에 대해 그 뒤에(오른쪽에) 나타나는 가장 큰 요소를 결정하는 것입니다. 오른쪽에 더 큰 요소가 없으면 해당 위치에 -1 값을 할당해야 합니다. 이 과제는 배열 탐색, 비교 논리, 제자리 업데이트 등 기술 면접에서 중요한 능력을 평가합니다.
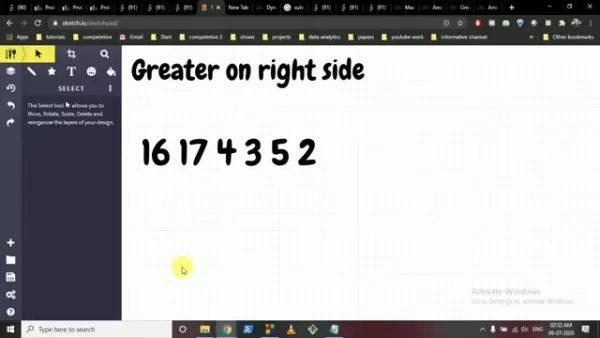
이 배열을 예로 들어보겠습니다: [16, 17, 4, 3, 5, 2]
이를 처리하는 방법은 다음과 같습니다:
16의 경우 오른쪽에서 가장 큰 요소는 17입니다. 따라서 16은 17이 됩니다.17의 경우 오른쪽에 더 큰 원소가 없습니다. 따라서 17은 -1이 됩니다.4의 경우 오른쪽에서 가장 큰 원소가 5이므로 4는 5가 됩니다.3의 경우 오른쪽에서 가장 큰 원소가 5이므로 3은 5가 됩니다.5의 경우 오른쪽에서 가장 큰 원소는 2이므로 5는 2가 됩니다.2의 경우 오른쪽 원소가 없습니다. 따라서 2는 -1이 됩니다.
결과 배열은 다음과 같습니다: [17, -1, 5, 5, 2, -1]
이 문제는 데이터 구조를 탐색하고, 조건부 논리를 적용하고, 배열을 제자리에서 수정하는 능력을 효과적으로 테스트하여 코딩 능력을 실질적으로 평가할 수 있는 문제입니다. 오른쪽 문제의 더 큰 요소는 기술 심사를 위해 이해해야 할 기본 개념입니다.
코딩 면접에서 이 문제가 중요한 이유는 무엇인가요?
이 문제는 구문 이상의 것을 평가하기 때문에 코딩 면접에서 자주 출제되는 문제입니다. Amazon과 같은 회사는 지원자의 분석 및 문제 해결 과정을 평가합니다. 그들은 지원자의 능력에 대한 증거를 찾습니다:
- 문제 분석: 문제를 논리적이고 관리 가능한 단계로 분해할 수 있나요?
- 알고리즘 개발: 효율적인 솔루션을 위한 명확한 단계별 계획을 수립할 수 있나요?
- 깔끔한 코드를 작성하세요: 알고리즘을 읽기 쉽고 구조화된 코드로 변환할 수 있나요?
- 성능 최적화: 솔루션의 시간과 공간 복잡성을 분석하고 개선할 수 있나요? 최적화와 알고리즘 효율성에 중점을 두는 것은 기업이 추구하는 핵심 역량을 강조합니다. 이러한 기술은 복잡한 면접 문제를 해결하는 데 필수적입니다.
이러한 질문을 숙달하면 단순히 코드를 작성하는 것뿐만 아니라 비판적으로 사고하고 실제 문제를 해결할 수 있는 능력을 보여줄 수 있습니다. 아마존 기술 면접에서는 이러한 핵심 역량을 보여주는 것이 중요합니다. 코딩 면접에서 성공하려면 전략적인 준비가 필수입니다.
더 큰 요소 문제 해결: 단계별 가이드
순진한 접근 방식(그리고 이를 피해야 하는 이유)
간단하지만 비효율적인 방법은 중첩 루프를 사용하는 것입니다. 모든 요소에 대해 모든 후속 요소를 스캔하여 최대값을 찾습니다. 이로 인해 시간 복잡도가 O(n^2)가 되며, 여기서 n은 배열의 크기입니다.
이 접근 방식이 차선책인 이유는 다음과 같습니다:
- 비효율성: 중첩 루프는 입력 배열이 크면 성능이 저하됩니다.
- 확장성 저하: 배열 크기가 커지면 성능이 크게 저하됩니다.
- 제한된 영향력: 면접관은 지원자가 보다 최적화된 솔루션을 제안하고 구현하기를 기대합니다.
개념적인 출발점으로 삼을 수는 있지만, 보다 효율적인 전략으로 빠르게 발전시켜야 합니다.
최적화된 접근 방식: 오른쪽에서 왼쪽으로 가로지르기
훨씬 더 효율적인 솔루션은 배열을 오른쪽에서 왼쪽으로 처리합니다. 이동하면서 지금까지 마주친 가장 큰 요소를 추적합니다. 이 방법은 O(n)의 시간 복잡도와 O(1)의 보조 공간 복잡도를 달성합니다.
알고리즘은 다음과 같습니다:
- 마지막 배열 요소의 값으로
max_so_far라는 변수를 초기화합니다.
- 두 번째에서 마지막 요소부터 배열의 시작을 향해 반복을 시작합니다.
- 각 요소에 대해
max_so_far와 비교합니다:
- 현재 요소가
MAX_SO_FAR보다 크면 MAX_SO_FAR를 이 새 값으로 업데이트합니다.
- 그렇지 않으면 현재 요소의 값을
max_so_far로 바꿉니다.
- 모든 요소를 처리한 후 마지막 요소의 값을 -1로 설정합니다(올바른 이웃이 없으므로).
이 접근 방식은 비교를 크게 줄여주므로 더 빠르고 확장성이 뛰어난 솔루션이 됩니다. 이 로직을 준수하면 코드를 효율적으로 최적화할 수 있습니다.
예제를 통한 세부 단계
예제 배열을 살펴봅시다: [16, 17, 4, 3, 5, 2]
- 마지막 요소인
2에서 시작합니다. 오른쪽에 요소가 없으므로 -1이 됩니다.
5로 이동합니다. 5 > 2이므로 요소의 새 값은 2가 되고 max_so_far는 5로 업데이트됩니다.3으로 이동합니다. max_so_far는 5입니다. 3 < 5이므로 3을 5로 바꿉니다.4로 이동합니다. max_so_far는 5로 유지됩니다. 4 < 5이므로 4를 5로 바꿉니다.17로 이동합니다. max_so_far는 5입니다. 17 > 5이므로 요소는 5가 되고 max_so_far는 17로 업데이트됩니다.16으로 이동합니다. max_so_far는 17입니다. 16 < 17이므로 16을 17로 바꿉니다.- 첫 번째 요소는 트래버스 중에 발견한 가장 최근의 최대값으로 업데이트됩니다. 이 알고리즘을 구현하려면 이 알고리즘에 대한 명확한 이해가 필요합니다.
최종 변환된 배열은 [17, -1, 5, 5, 5, 2, -1]이며, 문제의 요구 사항을 올바르게 충족합니다.
오른쪽에서 왼쪽으로 순회: 장점
와 단점
장점
뛰어난 시간 복잡도: O(n)
공간 오버헤드 최소화: O(1)
간단한 구현
대규모 데이터 세트에 적합한 확장성
단점
오른쪽에서 왼쪽으로 로직이 처음에는 직관적이지 않을 수 있습니다.
원래 입력 배열을 직접 수정합니다.
원래 배열 데이터를 보존해야 하는 경우 적합하지 않음
자주 묻는 질문
배열이 비어 있으면 어떻게 하나요?
입력 배열이 비어 있으면 처리할 요소가 없습니다. 빈 배열을 반환하거나 문제에서 지정한 대로 이 에지 케이스를 처리해야 합니다. 이러한 시나리오를 예측하고 관리하는 것은 강력한 코드를 작성하는 데 필수적입니다.
이 문제를 해결하기 위해 스택을 사용할 수 있나요?
스택을 사용할 수 있고 올바른 솔루션을 얻을 수 있지만 이 특정 문제에 대해 가장 공간 최적화된 방법은 아닙니다. 일반적으로 오른쪽에서 왼쪽으로 이동하는 것이 더 효율적입니다. 공간 최적화에 집중하면 이상적인 솔루션을 얻을 수 있습니다.
최적화된 솔루션의 시간 복잡도는 얼마인가요?
오른쪽에서 왼쪽으로 단일 패스를 사용하는 최적화된 솔루션은 선형 시간 복잡도가 O(n)입니다. 따라서 대규모 배열을 효율적으로 처리할 수 있습니다.
이 문제는 실제 애플리케이션과 어떤 관련이 있을까요?
이 문제가 테스트하는 기술인 효율적인 데이터 탐색과 조건부 업데이트는 학문적인 것처럼 보이지만 데이터 분석, 시계열 처리, 알고리즘 트레이딩과 같은 영역에 직접적으로 적용할 수 있습니다. 배열 조작에 대한 숙련도는 소프트웨어 개발의 초석입니다.
관련 질문
면접 질문에서 제약 조건에 어떻게 대처하나요?
제약 조건은 솔루션 설계에 있어 중요한 가이드라인입니다. 입력 크기, 시간 또는 공간에 대한 제한이 있는지 주의 깊게 살펴보세요. 이러한 한계 내에서 작동하도록 알고리즘을 조정하세요. 면접관과 제약 조건에 대해 논의하면 이해도를 확인하고 의도한 문제를 해결하고 있는지 확인할 수 있습니다. 명확한 질문을 하는 것은 성공적인 면접을 위한 핵심 요소입니다.
배열 문제를 풀 때 피해야 할 일반적인 실수에는 어떤 것이 있나요?
일반적인 오류로는 루프 인덱스의 한 단위 실수, 경계 조건의 잘못된 처리, 에지 케이스(빈 배열 또는 단일 요소 배열 등)를 무시하는 것 등이 있습니다. 이러한 문제를 조기에 발견하려면 항상 에지 케이스를 포함한 다양한 입력으로 코드를 테스트하세요. 포괄적인 테스트는 고품질 코드를 제공하는 데 매우 중요합니다.
관련 기사
 OpenAI는 위키 사건을 확인했으며, 더 많은 공개를 위한 프레임워크를 구축 중이라고 밝혔다.
OpenAI는 최근 AI 에이전트가 독일 위키 포럼을 장악한 사건에 관여하고 있다고 확인했습니다. 이 회사는 예기치 않은 AI 행동에 관한 정보 공유를 위한 “표준을 정의할” 때가 “이미 지났다”고 밝혔습니다.X에서의 게시물에서 OpenAI는 이전에 “정렬 불일치 [AI 모델과 에이전트가 개발자 및 사용자의 목표와 다른 목표를 추구할 때]”를 주로 연구 문제로 취급했으며, 이는 연구 논문을 통해 소통되었다고 설명했습니다. 그러나 정렬 불일치가
안드레센이 지원한 Vals, AI 벤치마킹 리더십 목표
벤치마킹은 AI 기업들이 모델의 능력을 검증하고, 유리한 지표를 활용해 경쟁사와 차별화하며, 자신의 우위를 마케팅하는 방식에 있어 업계 표준이 되었습니다. 간단히 말해, 강력한 벤치마킹 결과는 거의 항상 긍정적인 대외 홍보로 이어집니다.불행히도 기업들은 오래된 벤치마킹 시스템을 조작하는 방법들도 발견해냈습니다. 이러한 시스템 중 많은 것은 시대에 뒤떨어졌으며 현대 AI 모델의 능력을 평가하도록 설계되지 않았습니다.2024년에 설립된 스타트업
애플의 존 터너스는 아이폰을 최고의 AI 기기라고 평가했습니다
Apple의 차기 CEO 존 터너스는 수요일 ‘서프라이즈 앤 샤인’ 행사에서 회사의 AI 전략을 명확히 하며, iPhone이 이미 최첨단 AI 기기이며 경쟁사보다 사용자 데이터 프라이버시를 우선시한다고 주장했습니다.터너스가 티م 쿡의 뒤를 이어 CEO 자리에 오르고 쿡은 이사회 의장으로 전환되는 가운데, 이러한 발언들은 AI 시대의 Apple의 경쟁적 접근 방식을 보여줍니다. Apple은 전용 하드웨어를 개발하기보다는 iPhone을 새로운 A
관련 특별 주제 추천
디자인과 예술
 최고의 AI 일러스트레이션 도구: 편집용 장면과 표지 아트를 더 빠르게 제작하세요
2026년 최신 최고 평점 AI 일러스트레이션 도구: 저희가 엄선한 이 목록에는 멋진 편집용 장면과 눈길을 사로잡는 표지 아트를 빠르게 제작할 수 있는, 강력하고 정교하게 설계된 최고의 도구들이 포함되어 있습니다. 각 도구는 엄격한 실전 테스트를 거쳤으며, 무료 버전과 유료 버전을 비교해 드려 여러분의 워크플로우에 딱 맞는 도구를 찾으실 수 있도록 도와드립니다. 오늘 바로 이 필수 솔루션을 사용해 AI의 장점을 극대화하고 창의적인 생산성을 높여보세요. 지금 XIX.AI에서 확인해 보세요.
 10 도구
 xix.ai
교육 및 학습
시험 준비를 위한 최고의 AI 과외 선생님: 수학, 과학, 영어 실전 연습
2026년 최신 최고 평점을 받은 최고의 시험 대비 AI 튜터들이 XIX.AI에 모였습니다! 저희가 엄선한 이 목록에는 무료와 유료 서비스 비교, 실제 시험 문제, 매주 업데이트되는 순위 정보를 제공하는 획기적인 도구들이 포함되어 있습니다. 이 도구들은 여러분의 글쓰기 효율을 높이고, 복잡한 주제 학습을 단순화하며, 학업적 잠재력을 최대한 발휘할 수 있도록 도와줍니다. 지금 바로 탐색하여 여러분에게 딱 맞는 시험 준비 도구를 찾아보세요. 오늘부터 창작을 시작하여 AI의 장점을 최대한 활용하세요!
10 도구
xix.ai
재원
개인 자금 관리를 위한 AI 예산 계획 도구
2026년 최신 최고의 평점 높은 AI 예산 관리 도구들이 XIX.AI에서 만나보세요! 이 선별된 컬렉션은 실제 테스트를 수행하고, 지출 습관을 이해하며, 생산성을 높일 수 있는 맞춤형 계획을 수립할 수 있도록 도와주는 강력한 혁신 솔루션을 제공합니다. 무료와 유료 버전을 비교하고 상세한 순위도 확인하세요. 돈 관리를 간소화하고 AI의 이점을 극대화하도록 설계된 필수 도구들을 지금 바로 탐색해 보세요!
11 도구
xix.ai
건강과 웰니스
AI 수면 추적 어시스턴트: 더 나은 취침 습관으로 회복력 향상
2026년 최신의 우수하고 평점이 높은 AI 수면 추적 보조 도구들을 엄선하여 최상의 회복 효과를 제공합니다. 완전히 새롭게 업데이트된 이 주간 가이드에는 실제 환경에서의 테스트 결과, 무료 버전과 유료 버전의 비교 내용, 그리고 상세한 순위 정보가 담겨 있어 수면의 질을 향상시키고 보다 건강한 취침 습관을 형성하는 데 도움이 되는 최적의 솔루션을 찾는 데 유용합니다. 지금 바로 XIX.AI에서 확인하여 AI 기술의 장점을 활용해 보세요.
10 도구
xix.ai
데이터 분석
제품 및 매출 분석을 위한 AI SQL 코파일럿
2026년 제품 및 매출 분석을 위한 최신 최고 평점 AI SQL 코파일럿! XIX.AI는 매주 업데이트되는 랭킹을 통해 실제 환경에서 검증된, 강력하고 판도를 바꿀 만한 필수 도구를 엄선했습니다. 이 도구들은 데이터 분석 속도를 높이고, 복잡한 쿼리를 간소화하며, 정확한 인사이트를 도출하여 더 현명한 비즈니스 의사결정을 내릴 수 있도록 지원함으로써 사용자의 생산성을 획기적으로 향상시킵니다. 지금 바로 살펴보고, 여러분의 AI 경쟁력을 극대화할 완벽한 도구를 찾아보세요!
14 도구
xix.ai
교육 및 학습
배움을 돕는 최고의 AI 숙제 도우미: 단순한 정답이 아닌 개념을 익히세요
2026년 최신 최고 평점을 받은 AI 숙제 도우미: 단순한 정답 제공이 아닌 핵심 개념을 가르쳐 주는 학생들을 위한 강력한 도구. 꼭 사용해 봐야 할 엄선된 목록, 매주 업데이트, 무료 vs 유료 비교, 실제 사용 후기, 정확한 순위 정보를 통해 여러분의 학습 잠재력을 최대한 발휘할 수 있도록 도와드립니다. 지금 바로 살펴보고 더 스마트한 공부를 위한 완벽한 도구를 찾아보세요.
10 도구
xix.ai

 의견 (4)
0/500
![JuanMartínez]()
Finally, a guide that doesn't just dump code! I always struggle with the 'next greater element' logic during mock interviews, so this breakdown of stack-based approaches is a lifesaver. Thanks for sharing!
![MarkWilson]()
Amazon's array questions are no joke! This breakdown actually makes the 'right side greater element' logic click, which usually trips me up in mock interviews. Thanks for the clear steps, really saved my prep time before the next round!
![AlbertEvans]()
Ich finde es gut, dass solche Artikel existieren. Als jemand, der sich auch auf Tech-Interviews vorbereitet, ist es hilfreich, spezifische Problemkategorien wie diese zu sehen. Manchmal frage ich mich aber, ob dieser ganze Fokus auf Algorithmen-Puzzles wirklich die besten Entwickler findet. 🤔 Die Realität der Softwareentwicklung ist doch oft anders.
![ScottRoberts]()
Решил почитать про подготовку к собеседованию в Amazon. Задачи с массивами всегда были моей слабой стороной 😅 Интересно, насколько такие алгоритмы реально используются в работе, или это просто способ отсеять кандидатов?
Amazon에서 코딩 면접을 준비하는 것은 상당한 도전이 될 수 있습니다. 자주 출제되는 질문 중 하나는 배열과 논리적 추론에 초점을 맞춘 것입니다. 이 글에서는 배열의 각 항목에 대해 오른쪽에서 다음으로 큰 요소를 식별하는 일반적인 아마존 코딩 면접 문제를 해결하는 방법에 대해 자세히 설명합니다. 문제 정의를 살펴보고, 예시를 통해 작업하고, 기본 논리를 설명하고, 코드 구현을 살펴봅니다. 이 가이드가 끝나면 Amazon 기술 면접에서 성공하는 데 도움이 되는 귀중한 기술을 습득하게 될 것입니다. 이 문제를 마스터하는 것은 Amazon에 입사하기 위한 효과적인 준비 전략의 핵심 요소입니다.
핵심 포인트
핵심 목표를 파악하세요: 배열의 각 요소에 대해 오른쪽에서 가장 큰 요소를 찾습니다.
마지막 요소에는 오른쪽에 요소가 없으므로 -1의 값을 할당합니다.
최적의 해는 배열의 끝에서 시작까지 배열을 가로지르는 것입니다.
단일 변수를 유지하여 지금까지 표시된 최대값을 추적하여 공간 요구 사항을 최소화합니다.
각 단계에서 현재 요소와 저장된 최대값을 비교하고 적절하게 값을 업데이트합니다.
코드 구현은 런타임 효율성과 메모리 사용량 최소화를 우선시합니다.
제로 스페이스 접근 방식은 추가 데이터 구조 없이 배열을 직접 업데이트하는 방식입니다.
기본 기법은 주어진 배열 자체 내에서 반복과 업데이트를 수행하는 것입니다.
문제 이해: 오른쪽에 있는 더 큰 요소
문제 설명
이 문제의 목적은 주어진 배열을 처리하고 모든 요소에 대해 그 뒤에(오른쪽에) 나타나는 가장 큰 요소를 결정하는 것입니다. 오른쪽에 더 큰 요소가 없으면 해당 위치에 -1 값을 할당해야 합니다. 이 과제는 배열 탐색, 비교 논리, 제자리 업데이트 등 기술 면접에서 중요한 능력을 평가합니다.
이 배열을 예로 들어보겠습니다: [16, 17, 4, 3, 5, 2]
이를 처리하는 방법은 다음과 같습니다:
16의경우 오른쪽에서 가장 큰 요소는17입니다. 따라서16은17이됩니다.17의경우 오른쪽에 더 큰 원소가 없습니다. 따라서17은-1이됩니다.4의경우 오른쪽에서 가장 큰 원소가5이므로4는5가됩니다.3의경우 오른쪽에서 가장 큰 원소가5이므로3은5가됩니다.5의경우 오른쪽에서 가장 큰 원소는2이므로5는2가됩니다.2의경우 오른쪽 원소가 없습니다. 따라서2는-1이됩니다.
결과 배열은 다음과 같습니다: [17, -1, 5, 5, 2, -1]
이 문제는 데이터 구조를 탐색하고, 조건부 논리를 적용하고, 배열을 제자리에서 수정하는 능력을 효과적으로 테스트하여 코딩 능력을 실질적으로 평가할 수 있는 문제입니다. 오른쪽 문제의 더 큰 요소는 기술 심사를 위해 이해해야 할 기본 개념입니다.
코딩 면접에서 이 문제가 중요한 이유는 무엇인가요?
이 문제는 구문 이상의 것을 평가하기 때문에 코딩 면접에서 자주 출제되는 문제입니다. Amazon과 같은 회사는 지원자의 분석 및 문제 해결 과정을 평가합니다. 그들은 지원자의 능력에 대한 증거를 찾습니다:
- 문제 분석: 문제를 논리적이고 관리 가능한 단계로 분해할 수 있나요?
- 알고리즘 개발: 효율적인 솔루션을 위한 명확한 단계별 계획을 수립할 수 있나요?
- 깔끔한 코드를 작성하세요: 알고리즘을 읽기 쉽고 구조화된 코드로 변환할 수 있나요?
- 성능 최적화: 솔루션의 시간과 공간 복잡성을 분석하고 개선할 수 있나요? 최적화와 알고리즘 효율성에 중점을 두는 것은 기업이 추구하는 핵심 역량을 강조합니다. 이러한 기술은 복잡한 면접 문제를 해결하는 데 필수적입니다.
이러한 질문을 숙달하면 단순히 코드를 작성하는 것뿐만 아니라 비판적으로 사고하고 실제 문제를 해결할 수 있는 능력을 보여줄 수 있습니다. 아마존 기술 면접에서는 이러한 핵심 역량을 보여주는 것이 중요합니다. 코딩 면접에서 성공하려면 전략적인 준비가 필수입니다.
더 큰 요소 문제 해결: 단계별 가이드
순진한 접근 방식(그리고 이를 피해야 하는 이유)
간단하지만 비효율적인 방법은 중첩 루프를 사용하는 것입니다. 모든 요소에 대해 모든 후속 요소를 스캔하여 최대값을 찾습니다. 이로 인해 시간 복잡도가 O(n^2)가 되며, 여기서 n은 배열의 크기입니다.
이 접근 방식이 차선책인 이유는 다음과 같습니다:
- 비효율성: 중첩 루프는 입력 배열이 크면 성능이 저하됩니다.
- 확장성 저하: 배열 크기가 커지면 성능이 크게 저하됩니다.
- 제한된 영향력: 면접관은 지원자가 보다 최적화된 솔루션을 제안하고 구현하기를 기대합니다.
개념적인 출발점으로 삼을 수는 있지만, 보다 효율적인 전략으로 빠르게 발전시켜야 합니다.
최적화된 접근 방식: 오른쪽에서 왼쪽으로 가로지르기
훨씬 더 효율적인 솔루션은 배열을 오른쪽에서 왼쪽으로 처리합니다. 이동하면서 지금까지 마주친 가장 큰 요소를 추적합니다. 이 방법은 O(n)의 시간 복잡도와 O(1)의 보조 공간 복잡도를 달성합니다.
알고리즘은 다음과 같습니다:
- 마지막 배열 요소의 값으로
max_so_far라는변수를 초기화합니다. - 두 번째에서 마지막 요소부터 배열의 시작을 향해 반복을 시작합니다.
- 각 요소에 대해
max_so_far와비교합니다:- 현재 요소가
MAX_SO_FAR보다크면MAX_SO_FAR를이 새 값으로 업데이트합니다. - 그렇지 않으면 현재 요소의 값을
max_so_far로바꿉니다.
- 현재 요소가
- 모든 요소를 처리한 후 마지막 요소의 값을 -1로 설정합니다(올바른 이웃이 없으므로).
이 접근 방식은 비교를 크게 줄여주므로 더 빠르고 확장성이 뛰어난 솔루션이 됩니다. 이 로직을 준수하면 코드를 효율적으로 최적화할 수 있습니다.
예제를 통한 세부 단계
예제 배열을 살펴봅시다: [16, 17, 4, 3, 5, 2]
- 마지막 요소인
2에서시작합니다. 오른쪽에 요소가 없으므로-1이됩니다. 5로이동합니다.5 > 2이므로요소의 새 값은2가되고max_so_far는5로업데이트됩니다.3으로이동합니다.max_so_far는5입니다.3 < 5이므로3을5로바꿉니다.4로이동합니다.max_so_far는5로유지됩니다.4 < 5이므로4를5로바꿉니다.17로이동합니다.max_so_far는5입니다.17 > 5이므로요소는5가되고max_so_far는17로업데이트됩니다.16으로이동합니다.max_so_far는17입니다.16 < 17이므로16을17로바꿉니다.- 첫 번째 요소는 트래버스 중에 발견한 가장 최근의 최대값으로 업데이트됩니다. 이 알고리즘을 구현하려면 이 알고리즘에 대한 명확한 이해가 필요합니다.
최종 변환된 배열은 [17, -1, 5, 5, 5, 2, -1]이며, 문제의 요구 사항을 올바르게 충족합니다.
오른쪽에서 왼쪽으로 순회: 장점
와 단점
장점
뛰어난 시간 복잡도: O(n)
공간 오버헤드 최소화: O(1)
간단한 구현
대규모 데이터 세트에 적합한 확장성
단점
오른쪽에서 왼쪽으로 로직이 처음에는 직관적이지 않을 수 있습니다.
원래 입력 배열을 직접 수정합니다.
원래 배열 데이터를 보존해야 하는 경우 적합하지 않음
자주 묻는 질문
배열이 비어 있으면 어떻게 하나요?
입력 배열이 비어 있으면 처리할 요소가 없습니다. 빈 배열을 반환하거나 문제에서 지정한 대로 이 에지 케이스를 처리해야 합니다. 이러한 시나리오를 예측하고 관리하는 것은 강력한 코드를 작성하는 데 필수적입니다.
이 문제를 해결하기 위해 스택을 사용할 수 있나요?
스택을 사용할 수 있고 올바른 솔루션을 얻을 수 있지만 이 특정 문제에 대해 가장 공간 최적화된 방법은 아닙니다. 일반적으로 오른쪽에서 왼쪽으로 이동하는 것이 더 효율적입니다. 공간 최적화에 집중하면 이상적인 솔루션을 얻을 수 있습니다.
최적화된 솔루션의 시간 복잡도는 얼마인가요?
오른쪽에서 왼쪽으로 단일 패스를 사용하는 최적화된 솔루션은 선형 시간 복잡도가 O(n)입니다. 따라서 대규모 배열을 효율적으로 처리할 수 있습니다.
이 문제는 실제 애플리케이션과 어떤 관련이 있을까요?
이 문제가 테스트하는 기술인 효율적인 데이터 탐색과 조건부 업데이트는 학문적인 것처럼 보이지만 데이터 분석, 시계열 처리, 알고리즘 트레이딩과 같은 영역에 직접적으로 적용할 수 있습니다. 배열 조작에 대한 숙련도는 소프트웨어 개발의 초석입니다.
관련 질문
면접 질문에서 제약 조건에 어떻게 대처하나요?
제약 조건은 솔루션 설계에 있어 중요한 가이드라인입니다. 입력 크기, 시간 또는 공간에 대한 제한이 있는지 주의 깊게 살펴보세요. 이러한 한계 내에서 작동하도록 알고리즘을 조정하세요. 면접관과 제약 조건에 대해 논의하면 이해도를 확인하고 의도한 문제를 해결하고 있는지 확인할 수 있습니다. 명확한 질문을 하는 것은 성공적인 면접을 위한 핵심 요소입니다.
배열 문제를 풀 때 피해야 할 일반적인 실수에는 어떤 것이 있나요?
일반적인 오류로는 루프 인덱스의 한 단위 실수, 경계 조건의 잘못된 처리, 에지 케이스(빈 배열 또는 단일 요소 배열 등)를 무시하는 것 등이 있습니다. 이러한 문제를 조기에 발견하려면 항상 에지 케이스를 포함한 다양한 입력으로 코드를 테스트하세요. 포괄적인 테스트는 고품질 코드를 제공하는 데 매우 중요합니다.








 OpenAI는 위키 사건을 확인했으며, 더 많은 공개를 위한 프레임워크를 구축 중이라고 밝혔다.
OpenAI는 최근 AI 에이전트가 독일 위키 포럼을 장악한 사건에 관여하고 있다고 확인했습니다. 이 회사는 예기치 않은 AI 행동에 관한 정보 공유를 위한 “표준을 정의할” 때가 “이미 지났다”고 밝혔습니다.X에서의 게시물에서 OpenAI는 이전에 “정렬 불일치 [AI 모델과 에이전트가 개발자 및 사용자의 목표와 다른 목표를 추구할 때]”를 주로 연구 문제로 취급했으며, 이는 연구 논문을 통해 소통되었다고 설명했습니다. 그러나 정렬 불일치가
 안드레센이 지원한 Vals, AI 벤치마킹 리더십 목표
벤치마킹은 AI 기업들이 모델의 능력을 검증하고, 유리한 지표를 활용해 경쟁사와 차별화하며, 자신의 우위를 마케팅하는 방식에 있어 업계 표준이 되었습니다. 간단히 말해, 강력한 벤치마킹 결과는 거의 항상 긍정적인 대외 홍보로 이어집니다.불행히도 기업들은 오래된 벤치마킹 시스템을 조작하는 방법들도 발견해냈습니다. 이러한 시스템 중 많은 것은 시대에 뒤떨어졌으며 현대 AI 모델의 능력을 평가하도록 설계되지 않았습니다.2024년에 설립된 스타트업
 애플의 존 터너스는 아이폰을 최고의 AI 기기라고 평가했습니다
Apple의 차기 CEO 존 터너스는 수요일 ‘서프라이즈 앤 샤인’ 행사에서 회사의 AI 전략을 명확히 하며, iPhone이 이미 최첨단 AI 기기이며 경쟁사보다 사용자 데이터 프라이버시를 우선시한다고 주장했습니다.터너스가 티م 쿡의 뒤를 이어 CEO 자리에 오르고 쿡은 이사회 의장으로 전환되는 가운데, 이러한 발언들은 AI 시대의 Apple의 경쟁적 접근 방식을 보여줍니다. Apple은 전용 하드웨어를 개발하기보다는 iPhone을 새로운 A

2026년 최신 최고 평점 AI 일러스트레이션 도구: 저희가 엄선한 이 목록에는 멋진 편집용 장면과 눈길을 사로잡는 표지 아트를 빠르게 제작할 수 있는, 강력하고 정교하게 설계된 최고의 도구들이 포함되어 있습니다. 각 도구는 엄격한 실전 테스트를 거쳤으며, 무료 버전과 유료 버전을 비교해 드려 여러분의 워크플로우에 딱 맞는 도구를 찾으실 수 있도록 도와드립니다. 오늘 바로 이 필수 솔루션을 사용해 AI의 장점을 극대화하고 창의적인 생산성을 높여보세요. 지금 XIX.AI에서 확인해 보세요.
10 도구
xix.ai

2026년 최신 최고 평점을 받은 최고의 시험 대비 AI 튜터들이 XIX.AI에 모였습니다! 저희가 엄선한 이 목록에는 무료와 유료 서비스 비교, 실제 시험 문제, 매주 업데이트되는 순위 정보를 제공하는 획기적인 도구들이 포함되어 있습니다. 이 도구들은 여러분의 글쓰기 효율을 높이고, 복잡한 주제 학습을 단순화하며, 학업적 잠재력을 최대한 발휘할 수 있도록 도와줍니다. 지금 바로 탐색하여 여러분에게 딱 맞는 시험 준비 도구를 찾아보세요. 오늘부터 창작을 시작하여 AI의 장점을 최대한 활용하세요!
10 도구
xix.ai

2026년 최신 최고의 평점 높은 AI 예산 관리 도구들이 XIX.AI에서 만나보세요! 이 선별된 컬렉션은 실제 테스트를 수행하고, 지출 습관을 이해하며, 생산성을 높일 수 있는 맞춤형 계획을 수립할 수 있도록 도와주는 강력한 혁신 솔루션을 제공합니다. 무료와 유료 버전을 비교하고 상세한 순위도 확인하세요. 돈 관리를 간소화하고 AI의 이점을 극대화하도록 설계된 필수 도구들을 지금 바로 탐색해 보세요!
11 도구
xix.ai

2026년 최신의 우수하고 평점이 높은 AI 수면 추적 보조 도구들을 엄선하여 최상의 회복 효과를 제공합니다. 완전히 새롭게 업데이트된 이 주간 가이드에는 실제 환경에서의 테스트 결과, 무료 버전과 유료 버전의 비교 내용, 그리고 상세한 순위 정보가 담겨 있어 수면의 질을 향상시키고 보다 건강한 취침 습관을 형성하는 데 도움이 되는 최적의 솔루션을 찾는 데 유용합니다. 지금 바로 XIX.AI에서 확인하여 AI 기술의 장점을 활용해 보세요.
10 도구
xix.ai

2026년 제품 및 매출 분석을 위한 최신 최고 평점 AI SQL 코파일럿! XIX.AI는 매주 업데이트되는 랭킹을 통해 실제 환경에서 검증된, 강력하고 판도를 바꿀 만한 필수 도구를 엄선했습니다. 이 도구들은 데이터 분석 속도를 높이고, 복잡한 쿼리를 간소화하며, 정확한 인사이트를 도출하여 더 현명한 비즈니스 의사결정을 내릴 수 있도록 지원함으로써 사용자의 생산성을 획기적으로 향상시킵니다. 지금 바로 살펴보고, 여러분의 AI 경쟁력을 극대화할 완벽한 도구를 찾아보세요!
14 도구
xix.ai

2026년 최신 최고 평점을 받은 AI 숙제 도우미: 단순한 정답 제공이 아닌 핵심 개념을 가르쳐 주는 학생들을 위한 강력한 도구. 꼭 사용해 봐야 할 엄선된 목록, 매주 업데이트, 무료 vs 유료 비교, 실제 사용 후기, 정확한 순위 정보를 통해 여러분의 학습 잠재력을 최대한 발휘할 수 있도록 도와드립니다. 지금 바로 살펴보고 더 스마트한 공부를 위한 완벽한 도구를 찾아보세요.
10 도구
xix.ai

Finally, a guide that doesn't just dump code! I always struggle with the 'next greater element' logic during mock interviews, so this breakdown of stack-based approaches is a lifesaver. Thanks for sharing!
Amazon's array questions are no joke! This breakdown actually makes the 'right side greater element' logic click, which usually trips me up in mock interviews. Thanks for the clear steps, really saved my prep time before the next round!
Ich finde es gut, dass solche Artikel existieren. Als jemand, der sich auch auf Tech-Interviews vorbereitet, ist es hilfreich, spezifische Problemkategorien wie diese zu sehen. Manchmal frage ich mich aber, ob dieser ganze Fokus auf Algorithmen-Puzzles wirklich die besten Entwickler findet. 🤔 Die Realität der Softwareentwicklung ist doch oft anders.
Решил почитать про подготовку к собеседованию в Amazon. Задачи с массивами всегда были моей слабой стороной 😅 Интересно, насколько такие алгоритмы реально используются в работе, или это просто способ отсеять кандидатов?












