


 Hogar
El avance de la GPU Moortech S5000 impulsa el modelo de IA «Jiutian» de China Mobile
En la próxima 9.ª Cumbre Digital China, el modelo de lenguaje grande de uso general «Jiutian» 35B, desarrollado por China Mobile, hará su debut oficial ante el público. Como un avance significativo para el ecosistema informático nacional, Moore Threads ha anunciado recientemente que su GPU insignia y con todas las funciones, la MTT S5000, ha completado la adaptación de todo el proceso y la verificación de la inferencia para este modelo.
La clave de esta adaptación reside en una profunda integración. Aprovechando su pila de software patentada MUSA y el motor de inferencia de alto rendimiento SGLang-MUSA, Moore Threads ha implementado con éxito todo el proceso de inferencia para el modelo «Jiutian» 35B. Mediante la optimización colaborativa del marco de desarrollo MUSA C, la biblioteca de computación muDNN y la biblioteca de operadores de código abierto MATE, la MTT S5000 se ha ajustado con precisión a los mecanismos de atención específicos y a los requisitos de inferencia de secuencias largas de los modelos de gran tamaño. Esto garantiza un rendimiento eficiente y estable al procesar textos extensos y gestionar solicitudes de alta concurrencia.
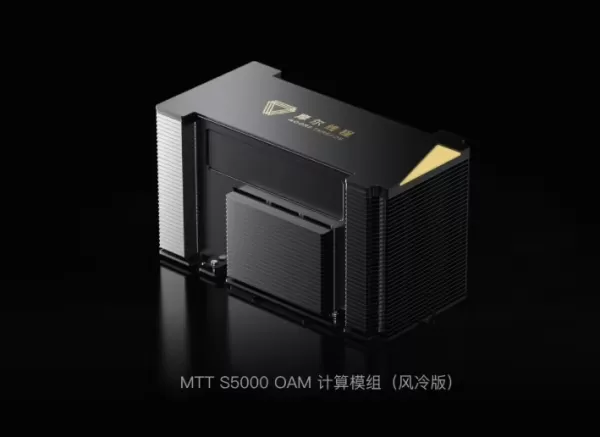
La tarjeta de computación MTT S5000, que sirve de base técnica para esta adaptación, ha demostrado unas capacidades excepcionales. Basada en la arquitectura MUSA «Pinghu» de cuarta generación, esta GPU ofrece una potencia máxima de computación densa de IA de hasta 1000 TFLOPS por tarjeta. Su configuración de hardware cuenta con 80 GB de VRAM de alta capacidad con un ancho de banda de memoria de 1,6 TB/s, lo que admite la computación de precisión completa desde FP8 hasta FP64. Además, un elevado ancho de banda de interconexión entre tarjetas de 784 GB/s garantiza una excelente escalabilidad en escenarios complejos de computación inteligente.
Esta colaboración no solo valida la fiabilidad de las GPU nacionales a la hora de dar soporte a los grandes modelos centrales de las empresas estatales, sino que también pone de relieve la madurez de Moore Threads en la optimización de operadores de alto rendimiento y el desarrollo de ecosistemas de software. Con el lanzamiento oficial del modelo «Jiutian» de 35 000 millones de parámetros, esta combinación de «gran modelo nacional + potencia de cálculo nacional» ofrece un caso práctico de gran relevancia para lograr una infraestructura de cálculo independiente y controlable.
Artículo relacionado
 Meta quiere que tu próximo gadget esté impulsado por Muse
El asistente de inteligencia artificial de Meta, Muse, que se encarga de reservas de viajes, envío de formularios y compras, ha ganado una amplia adopción, pero una nueva iniciativa puede interesar especialmente a desarrolladores y entusiastas del ha
Wan-Streamer v0.2 ofrece un chat de IA con latencia ultrabaja
A medida que la tecnología moderna avanza rápidamente, la interacción entre humanos e inteligencia artificial se vuelve más común. Las videollamadas tradicionales a menudo luchan con retrasos, demoras y desincronización audiovisual. Wan-Streamer v0.2
Meta se une a TSMC y Micron para equipar nuevos servidores con memoria antigua
A medida que la adopción de la inteligencia artificial se acelera en todo el mundo, la memoria DDR5 de próxima generación está experimentando una grave escasez de suministro. Para evitar retrasos en los despliegues de centros de datos de IA, Meta ha
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (0)
0/500
En la próxima 9.ª Cumbre Digital China, el modelo de lenguaje grande de uso general «Jiutian» 35B, desarrollado por China Mobile, hará su debut oficial ante el público. Como un avance significativo para el ecosistema informático nacional, Moore Threads ha anunciado recientemente que su GPU insignia y con todas las funciones, la MTT S5000, ha completado la adaptación de todo el proceso y la verificación de la inferencia para este modelo.
La clave de esta adaptación reside en una profunda integración. Aprovechando su pila de software patentada MUSA y el motor de inferencia de alto rendimiento SGLang-MUSA, Moore Threads ha implementado con éxito todo el proceso de inferencia para el modelo «Jiutian» 35B. Mediante la optimización colaborativa del marco de desarrollo MUSA C, la biblioteca de computación muDNN y la biblioteca de operadores de código abierto MATE, la MTT S5000 se ha ajustado con precisión a los mecanismos de atención específicos y a los requisitos de inferencia de secuencias largas de los modelos de gran tamaño. Esto garantiza un rendimiento eficiente y estable al procesar textos extensos y gestionar solicitudes de alta concurrencia.
La tarjeta de computación MTT S5000, que sirve de base técnica para esta adaptación, ha demostrado unas capacidades excepcionales. Basada en la arquitectura MUSA «Pinghu» de cuarta generación, esta GPU ofrece una potencia máxima de computación densa de IA de hasta 1000 TFLOPS por tarjeta. Su configuración de hardware cuenta con 80 GB de VRAM de alta capacidad con un ancho de banda de memoria de 1,6 TB/s, lo que admite la computación de precisión completa desde FP8 hasta FP64. Además, un elevado ancho de banda de interconexión entre tarjetas de 784 GB/s garantiza una excelente escalabilidad en escenarios complejos de computación inteligente.
Esta colaboración no solo valida la fiabilidad de las GPU nacionales a la hora de dar soporte a los grandes modelos centrales de las empresas estatales, sino que también pone de relieve la madurez de Moore Threads en la optimización de operadores de alto rendimiento y el desarrollo de ecosistemas de software. Con el lanzamiento oficial del modelo «Jiutian» de 35 000 millones de parámetros, esta combinación de «gran modelo nacional + potencia de cálculo nacional» ofrece un caso práctico de gran relevancia para lograr una infraestructura de cálculo independiente y controlable.








 Meta quiere que tu próximo gadget esté impulsado por Muse
El asistente de inteligencia artificial de Meta, Muse, que se encarga de reservas de viajes, envío de formularios y compras, ha ganado una amplia adopción, pero una nueva iniciativa puede interesar especialmente a desarrolladores y entusiastas del ha
 Wan-Streamer v0.2 ofrece un chat de IA con latencia ultrabaja
A medida que la tecnología moderna avanza rápidamente, la interacción entre humanos e inteligencia artificial se vuelve más común. Las videollamadas tradicionales a menudo luchan con retrasos, demoras y desincronización audiovisual. Wan-Streamer v0.2
 Meta se une a TSMC y Micron para equipar nuevos servidores con memoria antigua
A medida que la adopción de la inteligencia artificial se acelera en todo el mundo, la memoria DDR5 de próxima generación está experimentando una grave escasez de suministro. Para evitar retrasos en los despliegues de centros de datos de IA, Meta ha

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai












