
Option
Heim
Eilmeldung
Inhalt
SamuelClark
SamuelClark
23. Juli 2026

Das Dots Infra-Team von Xiaohongshu hat „BigMac“ als Open-Source-Projekt veröffentlicht, ein Paradigma für das parallele Training multimodaler großer Sprachmodelle (LLMs) mittels einer Pipeline. Dabei werden die Berechnungen von Encoder und Generator in einen optimierten LLM-Zeitplan eingebettet, wodurch der Kompromiss zwischen Rechengeschwindigkeit und Speicherverbrauch aufgehoben wird. Bei Verständnisaufgaben erzielt BigMac eine 1,08- bis 1,9-fache Beschleunigung gegenüber Baseline-Modellen bei stabilem Speicherverbrauch; bei Generierungsaufgaben vermeidet es OOM-Fehler und liefert gleichzeitig eine 1,5- bis 1,9-fache Beschleunigung.
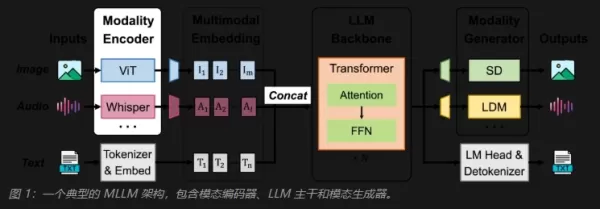
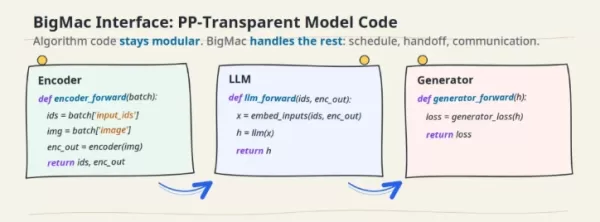
Das Dots Infra-Team von Xiaohongshu hat „BigMac“ als Open-Source-Projekt veröffentlicht, ein Paradigma für das parallele Training multimodaler großer Sprachmodelle (LLMs) mittels einer Pipeline. Dabei werden die Berechnungen von Encoder und Generator in einen optimierten LLM-Zeitplan eingebettet, wodurch der Kompromiss zwischen Rechengeschwindigkeit und Speicherverbrauch aufgehoben wird. Bei Verständnisaufgaben erzielt BigMac eine 1,08- bis 1,9-fache Beschleunigung gegenüber Baseline-Modellen bei stabilem Speicherverbrauch; bei Generierungsaufgaben vermeidet es OOM-Fehler und liefert gleichzeitig eine 1,5- bis 1,9-fache Beschleunigung. Das Dots Infra-Team von Xiaohongshu hat „BigMac“ als Open-Source-Projekt veröffentlicht, ein Paradigma für das parallele Training multimodaler großer Sprachmodelle (LLMs) mittels einer Pipeline. Dabei werden die Berechnungen von Encoder und Generator in einen optimierten LLM-Zeitplan eingebettet, wodurch der Kompromiss zwischen Rechengeschwindigkeit und Speicherverbrauch aufgehoben wird. Bei Verständnisaufgaben erzielt BigMac eine 1,08- bis 1,9-fache Beschleunigung gegenüber Baseline-Modellen bei stabilem Speicherverbrauch; bei Generierungsaufgaben vermeidet es OOM-Fehler und liefert gleichzeitig eine 1,5- bis 1,9-fache Beschleunigung.
Kommentare (0)
0/300
OR