
opción
Hogar
Última hora
Contenido
ChristopherAllen
ChristopherAllen
28 de mayo de 2026

NVIDIA ha hecho disponible bajo código abierto a Polar, un marco de entrenamiento basado en el aprendizaje reforzado que integra agentes de código existentes como Codex, Claude Code y Qwen Code en el proceso de entrenamiento GRPO sin necesidad de modificar el código original. Este framework considera los límites de las API de los modelos como puntos de entrada para el entrenamiento, lo que permite la intercepción de los procesos y la reconstrucción de los datos generados durante el entrenamiento. En las pruebas SWE-Bench, el porcentaje de éxito de Codex aumentó significativamente, pasando del 3.8% al 26.4%, mientras que el tiempo necesario para completar el entrenamiento se redujo en un 5.39 veces, y la tasa de utilización de la GPU aumentó del 20.4% al 87.7%.
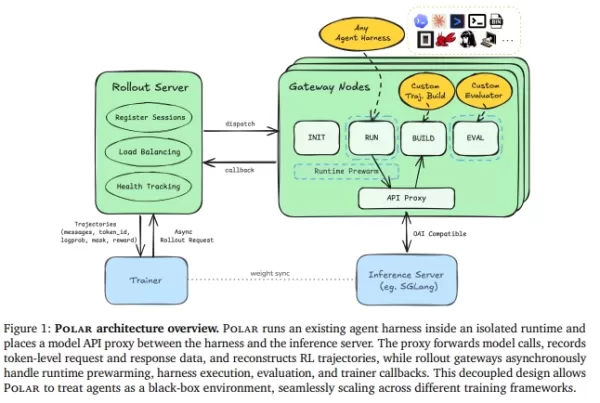
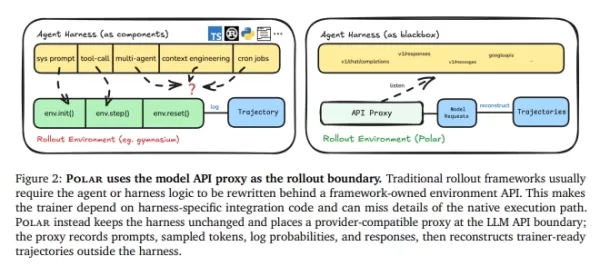
NVIDIA ha hecho disponible bajo código abierto a Polar, un marco de entrenamiento basado en el aprendizaje reforzado que integra agentes de código existentes como Codex, Claude Code y Qwen Code en el proceso de entrenamiento GRPO sin necesidad de modificar el código original. Este framework considera los límites de las API de los modelos como puntos de entrada para el entrenamiento, lo que permite la intercepción de los procesos y la reconstrucción de los datos generados durante el entrenamiento. En las pruebas SWE-Bench, el porcentaje de éxito de Codex aumentó significativamente, pasando del 3.8% al 26.4%, mientras que el tiempo necesario para completar el entrenamiento se redujo en un 5.39 veces, y la tasa de utilización de la GPU aumentó del 20.4% al 87.7%. NVIDIA ha hecho disponible bajo código abierto a Polar, un marco de entrenamiento basado en el aprendizaje reforzado que integra agentes de código existentes como Codex, Claude Code y Qwen Code en el proceso de entrenamiento GRPO sin necesidad de modificar el código original. Este framework considera los límites de las API de los modelos como puntos de entrada para el entrenamiento, lo que permite la intercepción de los procesos y la reconstrucción de los datos generados durante el entrenamiento. En las pruebas SWE-Bench, el porcentaje de éxito de Codex aumentó significativamente, pasando del 3.8% al 26.4%, mientras que el tiempo necesario para completar el entrenamiento se redujo en un 5.39 veces, y la tasa de utilización de la GPU aumentó del 20.4% al 87.7%.
comentario (0)
0/300
OR